以前講:
AI Voice Agent,
畫面通常很簡單。
你對著:
電話。
App。
智慧音箱
說話。
AI 回你:
一個聲音。
現在 Google 想再往前一步。
不只:
讓 AI 說話。
而是:
讓你看到一個正在和你說話的 AI。
Google 9 月 24 日正式推出:
Gemini 3.8 Live with Live Avatar。
它把:
即時語音。
即時視覺理解。
虛擬人物。
後端 Agent Workflow
放進:
同一個即時對話體驗。
最適合的場景不是:
「幫我寫一篇文章。」
而是:
需要人一直互動的工作。
例如:
客服。
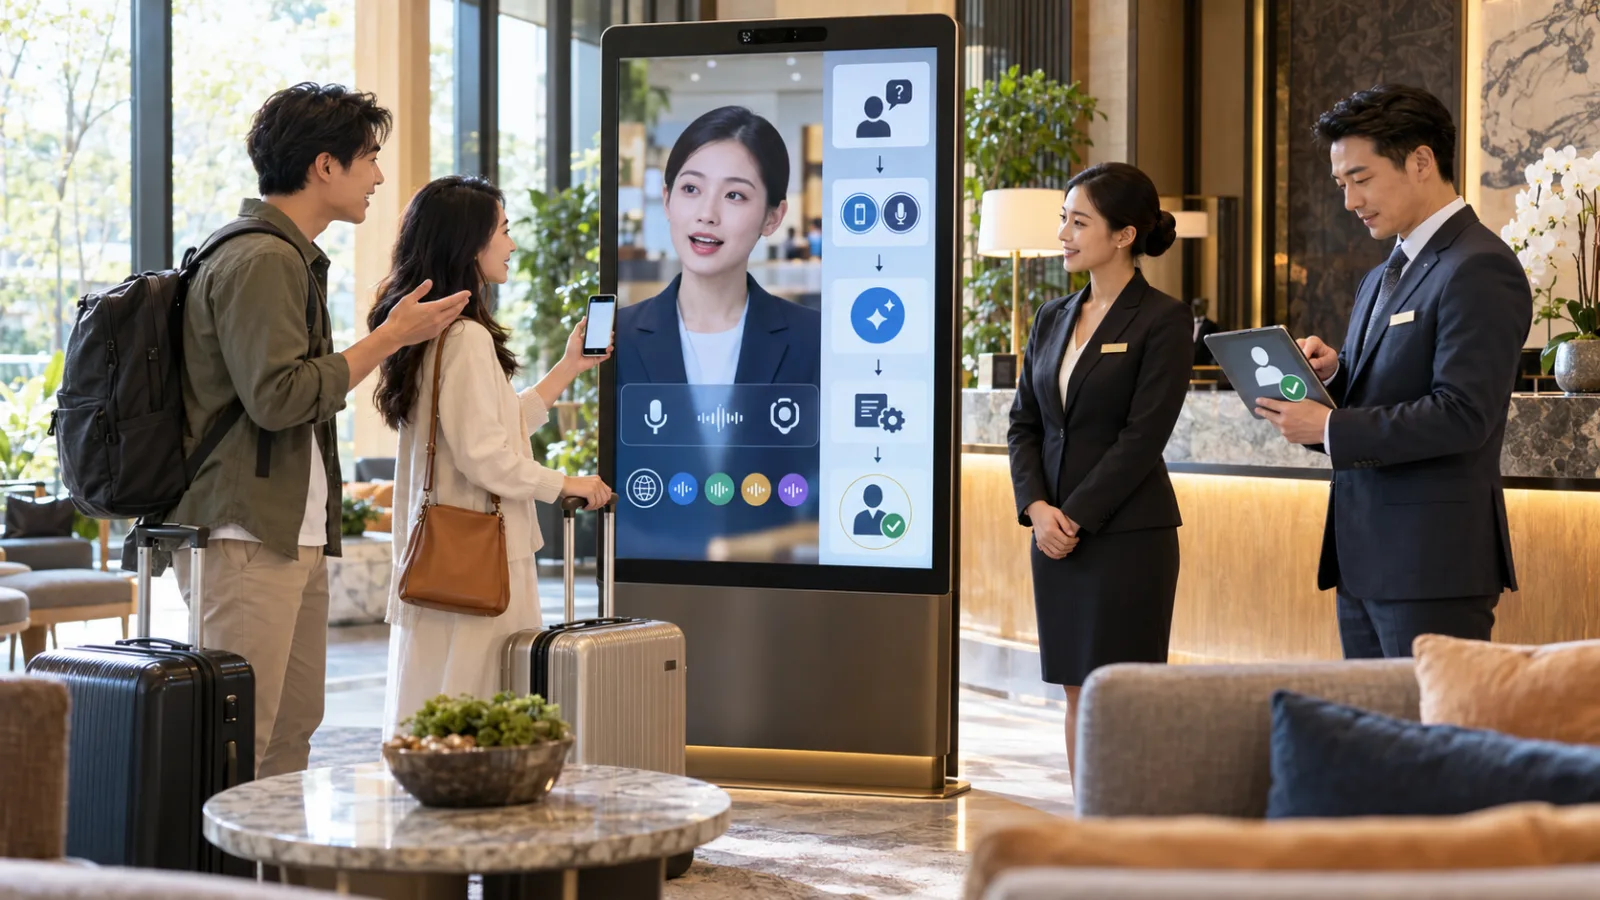
旅館櫃台。
展場導覽。
教育。
產品諮詢。
遠端協助。
先搞懂:Live Avatar 不是普通 AI 生影片
這點很重要。
一般 AI Avatar 工具:
可能是你先輸入:
一段 Script。
再等 AI:
生成一段影片。
Gemini 3.8 Live with Live Avatar
不是這種工作方式。
它比較像:
即時 Video Call。
你說一句。
Avatar:
即時理解。
即時回答。
嘴型跟著:
AI 產生的聲音。
表情也跟著:
Conversation
動態改變。
不是:
先把整段影片做完
再播放。
Google 把它建立在 Gemini 3.8 Live 上
Gemini 3.8 Live
本來就是:
Real-time Conversational Model。
和一般:
文字 Prompt
最大的不同是:
它直接做:
Speech-to-Speech。
也就是:
你說話。
AI 不一定先完整轉成文字、
再產文字、
再交給另一套 TTS。
Google 把:
聽。
理解。
回答。
說話
放進:
同一個 Live Model。
這也是為什麼:
它比較適合:
Continuous Conversation。
Live Avatar 再多加一層「視覺存在」
Google 現在把:
Video Avatar
同步加入。
官方表示:
Live Avatar 可以根據生成語音:
同步:
Lip-sync。
Facial Expression。
Conversation Response。
所以使用者不只是:
聽到一個 Voice Bot。
而是:
看到一個:
正在對自己說話的數位角色。
而且支援 97 種語言
這是它最適合:
跨國客服
的一個地方。
Google 表示:
Gemini 3.8 Live with Live Avatar
可以:
理解和說:
97 種語言。
而且可以:
Automatic Language Detection。
甚至:
對話中切換語言。
Avatar 的:
嘴型。
表情
仍會跟著改。
所以假設:
飯店櫃台。
第一個客人說:
英文。
第二個:
日文。
第三個:
西班牙文。
理論上:
不需要替每種語言
另外做一套:
預錄 Avatar Video。
同一套 Live Agent
可以:
動態切換。
這和傳統多語客服成本差很多
以前做:
Digital Human。
如果有:
10 種語言。
常常意味著:
10 套:
語音。
Script。
Recording。
Avatar Content。
更新一次內容:
可能全部重做。
Live Avatar 的方向是:
內容在對話當下生成。
所以企業真正維護的是:
Knowledge。
Rules。
Backend Tools。
Permissions。
不是:
幾千支預錄影片。
它不只「聽」,也能看
這點比 Avatar 外表:
更實用。
Gemini 3.8 Live
支援:
Live Visual Understanding。
也就是可以同時理解:
Camera Feed。
Screen Share。
Audio。
所以使用者可以:
邊說。
邊給 AI 看東西。
例如飯店旅客可以直接把畫面給它看
假設客人說:
「我訂房資料裡是不是含早餐?」
然後:
把手機畫面
對著 Camera。
理想 Workflow 可以是:
Avatar:
先理解:
使用者正在看的畫面。
再搭配:
後端訂房資料。
回答:
目前能確認的內容。
如果牽涉:
改房型。
退款。
加價。
付款。
再進:
人工或 Approval Step。
這比:
叫客人把:
訂單編號。
姓名。
方案。
日期
全部念一遍,
自然很多。
遠端技術支援也可能很適合
例如:
客戶不知道:
Router 哪一顆燈有問題。
以前:
客服:
「你看左邊第三顆燈。」
客戶:
「哪一顆?」
客服:
「不是那個。」
如果 AI 可以:
直接看:
Camera Feed,
使用者可以:
把鏡頭對著設備。
AI:
根據畫面
一步一步說:
下一步要看哪裡。
注意:
這只是:
適合 Live Visual Understanding
的一種使用情境。
不是說:
Gemini 已經內建每一家 Router
的維修資料。
企業仍然要:
接自己的:
Knowledge Base。
Product Data。
Service Workflow。
Screen Share 更適合軟體客服
例如:
客戶說:
「我找不到 Export。」
與其:
一來一往描述:
左上角。
右上角。
Settings。
Menu。
如果 Agent:
可以看到:
使用者分享的畫面,
它就能:
根據:
目前 UI State
直接指導。
這會比:
只聽文字描述
少很多:
Context Loss。
真正有趣的其實不是 Avatar,而是「邊聊邊做」
Google Cloud 對 Gemini 3.8 Live
特別強調:
即時對話期間,
Agent 可以搭配:
Backend Tools。
API。
其他企業系統
完成工作。
而對話:
不用因此完全停下來。
這件事非常關鍵。
因為傳統 Voice Bot:
很容易變成:
客人說一句。
停。
系統查資料。
停。
再回答。
非常不像真人。
Google 想做的是:
例如:
「我幫你查一下。」
Agent:
背景處理。
同時還能:
維持對話 Context。
這才是真正的「Live Agent」
不是:
一個動畫人物
在嘴巴動。
而是:
它背後可以:
理解。
查資料。
使用工具。
處理 Workflow。
Avatar:
只是:
把這些能力
變成:
更像面對面互動的入口。
哪些場景最可能先有價值?
第一:Customer Service
適合:
高頻。
重複。
但又需要:
語音互動
的問題。
例如:
訂單查詢。
產品說明。
基本故障排除。
政策解說。
第二:Hospitality/Tourism
飯店。
機場服務。
旅遊資訊。
展館。
Visitor Center。
這些地方:
天然就有:
多語需求。
而且很多問題:
重複性很高。
第三:Education
例如:
Virtual Tutor。
學生:
可以用語音問。
甚至:
把畫面、
作業、
示意圖
給 Agent 看。
Agent:
再即時回應。
但涉及:
評分。
重要教育判斷。
仍然要另外設計:
Human Review。
第四:Retail
例如:
店內 Kiosk。
顧客可以:
拿商品給鏡頭看。
問:
差異。
規格。
用途。
庫存。
如果再連:
企業正式商品資料,
就能:
減少:
人工重新查詢。
但:
價格。
促銷。
庫存
仍然應該以:
正式 Backend Data
為準。
不能讓模型:
自己猜。
第五:Remote Assistance
特別適合:
「我不知道怎麼描述我看到的東西。」
例如:
設備。
軟體畫面。
產品組裝。
操作步驟。
讓 Agent:
看到同一個畫面,
通常比:
人一直用文字解釋
容易很多。
但現在一定要知道:這不是一般 Gemini App 的新按鈕
今天如果看到:
Live Avatar
就立刻打開:
Gemini App
找:
「Avatar Mode。」
很可能:
找不到。
因為 Google 現在正式公布的是:
Gemini Enterprise。
以及:
API。
它的主要對象是:
Developer。
Enterprise。
要拿來:
建立自己的:
Customer Service。
Tutor。
Concierge。
Kiosk。
Agent Experience。
不是:
一般消費者今天換一個頭像
就能直接視訊聊天。
Gemini 3.8 Live 已經是 GA
這一點也要和:
Demo
分清楚。
Google Cloud 已經把:
Gemini 3.8 Live with Live Avatar
列為:
Generally Available。
也就是:
可以拿來:
Production。
不是只有:
Private Research Demo。
目前提供:
US。
EU
Multi-region Endpoint。
支援:
Pay-as-you-go。
也支援:
Provisioned Throughput。
但 Custom Avatar 還沒有完全開放
Google 有提供:
Preset Avatar。
也就是:
預先準備好的虛擬人物。
如果企業想做:
自己的品牌角色。
或者:
用一張高品質 Reference Image
建立:
具有指定外觀的 Avatar,
目前:
Custom Avatar Creation
仍然需要:
Enterprise Allowlist。
所以不能寫成:
「今天所有人都能上傳一張照片,立刻做成 Gemini Live Avatar。」
還不是。
而且「可以保留人物外觀」會立刻碰到身份問題
Avatar 一旦可以:
從 Reference Image
建立,
最大的風險就是:
假冒真人。
Deepfake。
品牌冒用。
Google 表示:
Live Avatar
針對:
Identity
加入安全設計。
所有 AI 生成的:
Audio。
Video
也會加入:
SynthID。
SynthID
是:
不可見的 AI Watermark。
目的是讓:
生成內容
未來更容易被:
辨識。
但 SynthID 不等於「不會被濫用」
這一點和我們以前談:
AI Image/Video
一樣。
Watermark:
是:
Provenance Signal。
不是:
Permission。
不是:
肖像權授權。
也不是:
企業可以隨便用任何人的臉。
真正做 Custom Avatar
仍然要確認:
人物授權。
品牌授權。
使用範圍。
告知。
資料保存政策。
如果是客服,還要再加一條:不能讓 Avatar 外表提高錯誤可信度
這可能是:
Live Avatar
很容易被忽略的問題。
純文字 AI:
講錯。
人還比較容易:
懷疑。
一個:
看著你。
點頭。
表情自然。
聲音流暢。
嘴型同步
的 Avatar:
如果講錯,
反而可能:
更容易讓人相信。
所以:
「看起來比較像真人」
不等於:
「答案比較準。」
企業真正要管的:
仍然是:
Grounding。
Knowledge。
Permissions。
Escalation。
客服最重要的不是「像不像真人」
真正 KPI
應該看:
問題有沒有解決?
回答正不正確?
第一次解決率多少?
多少必須:
轉真人?
高風險 Action
有沒有:
正確停下?
客戶最後:
有沒有少花時間?
如果 Avatar:
做得非常逼真,
但:
一直答錯庫存。
那只是:
一個很漂亮的錯誤介面。
導入時最適合先做「低風險+高頻」
例如:
營業時間。
基本服務介紹。
場館方向。
產品操作步驟。
預約流程說明。
訂單狀態。
這些:
有正式資料。
容易驗證。
重複性高。
先測:
Live Agent
到底能不能:
比傳統 Voice Bot
更自然地完成。
不要第一天就讓它處理:
付款。
退款。
取消訂單。
正式合約。
醫療判斷。
重大財務決策。
敏感個資修改。
原因不是:
AI Avatar 特別危險。
而是:
這些 Action
本來就應該:
有更強 Approval。
可以先設三層工作
第一層:回答
查:
正式 Knowledge Base。
回答問題。
第二層:準備
幫忙:
填資料。
整理需求。
準備 Action。
第三層:執行
退款。
付款。
取消。
改訂單。
正式送出。
第一層:
可以自動化多一點。
越往第三層:
越需要:
Human Approval。
這才是:
企業 Agent
比較合理的設計。
Google 也把 Live Avatar 做成 24 FPS 即時影片
Developer Guide
目前描述:
Gemini 3.8 Live
可直接生成:
同步的:
24 FPS Live Avatar Video。
搭配:
24 kHz Audio。
核心目標是:
Continuous Conversation。
也就是:
不要讓 Avatar:
像早期 Digital Human
一樣:
說一句。
停。
畫面卡一下。
再換下一句。
真正要接近的是:
自然:
插話。
停頓。
轉換話題。
繼續 Context。
它還會聽語氣
Gemini 3.8 Live
加入:
Affective Dialogue。
模型可以從:
Prosody。
語氣。
停頓。
Speech Inflection
判斷:
使用者目前的:
情緒與說話狀態。
再調整:
Voice Tone。
Conversation Rhythm。
例如:
客人已經很急,
AI 不應該還:
慢慢講五段背景。
不過:
這仍然是:
模型判斷。
不能把它當成:
真正的心理分析。
另外有 Proactive Audio
Google 也加入:
Background Audio Filtering。
模型會盡量區分:
真正對它說的話
和:
旁邊的背景聲。
這對:
大廳。
展場。
商店。
機場
非常重要。
因為真實環境:
不會像 Demo Room
那麼安靜。
成本也不能只看「一個 Avatar 多少錢一個月」
這是:
API/Enterprise Tool。
Google Cloud 的計價方式
不是:
固定一個:
「Avatar Pro 每月 20 美元。」
而是:
依:
Text Input。
Image/Video Input。
Audio Input。
Text Output。
Audio Output。
Avatar Video Output
分開計量。
另外也有:
Pay-as-you-go。
Provisioned Throughput。
所以真正做企業專案時,
應該算:
Cost per Completed Conversation。
不是:
只看模型單價。
例如客服真正應該計算:
每次互動:
平均幾分鐘?
輸入多少 Audio?
有沒有 Camera Feed?
Avatar Video 開多久?
後端 Tool Call 幾次?
最後:
多少問題真的解決?
如果:
一通 AI Avatar 客服
成本比真人便宜,
但:
50% 還是轉真人,
就要:
把兩邊成本
一起算。
所以 Live Avatar 最適合的第一個 Pilot
不要先做:
「取代全部客服。」
先選:
一個:
很窄的問題。
例如:
飯店:
Check-in/設施/早餐說明。
展館:
動線與展品基本資訊。
零售:
產品規格與門市查詢。
SaaS:
帳號設定與常見操作。
跑:
100~500 次真實互動。
看:
回答正確率。
平均處理時間。
轉真人率。
客戶滿意度。
每次解決成本。
再決定:
要不要擴大。
Live Avatar 真正重要的地方,不是「AI 終於有一張臉」
AI Avatar:
早就不是新概念。
真正新的是:
以前:
Avatar
是一個:
Presentation Layer。
背後常常只是:
預錄 Script。
現在:
Avatar
開始直接長在:
Real-time Agent
上面。
它能:
聽。
看。
回答。
維持 Context。
搭配 Backend Workflow。
再透過:
一個視覺角色
和人持續互動。
這才是:
今天最值得注意的地方。
也因此,人機互動會多出一個新問題
以前:
網站 Chatbot
只要讓使用者知道:
「這是 AI。」
相對簡單。
未來一個:
表情自然。
嘴型同步。
聲音有情緒。
長得像真人
的數位客服,
企業更需要:
清楚告知:
這不是人類。
哪些資訊:
會被收集。
Camera:
有沒有開。
Screen:
分享了什麼。
對話:
會不會保存。
哪些 Action:
可以自動做。
哪些:
會轉真人。
AI 越像真人,
透明度反而越不能降低。
台灣使用者今天應該怎麼看這個工具?
如果你只是:
一般 Gemini 使用者,
今天不用急著找:
Live Avatar 按鈕。
它現在不是:
一個大眾版濾鏡功能。
如果你是:
企業。
開發者。
做:
客服。
教育。
導覽。
互動式產品。
真正值得研究的是:
原本只有 Voice/Chat 的流程,有沒有哪一步因為「AI 可以看見+有視覺角色」而真的變更好?
如果沒有,
根本不用:
硬加 Avatar。
因為畫面本身不是 ROI
一個客服問題:
純 Voice
30 秒解決。
加 Avatar
仍然:
30 秒。
而客戶:
也不在意看到臉。
那 Avatar:
可能只是:
增加成本。
但如果場景需要:
建立信任。
示範操作。
看使用者畫面。
跨語言服務。
長時間互動。
那:
視覺存在
才可能真的:
改變體驗。
最後記住一句話
Gemini 3.8 Live with Live Avatar
真正的進步,
不是:
「AI 終於會做一張會動的臉。」
而是:
「即時 Agent 開始同時能聽、能看、能說,還能用一個持續存在的視覺角色和人完成工作。」
但越像真人,
越需要把:
身份。
資料。
權限。
轉真人條件
講清楚。
所以今天最值得測的,
不是:
Avatar 到底多逼真。
而是:
它有沒有真的讓一段原本卡住的人機互動,變得更快、更清楚,而且仍然知道什麼時候該把決定權交回給人。
今天,和 AI 一起進步一點。
每天學會一個 AI 技巧。
每天節省一點時間。
每天提升一點能力。
SasaDaily,陪你一起成長。
推薦閱讀
今日 AI 工具|2026/08/27:Gemini Live 新版,直接用語音整理 Gmail、聽 Daily Brief,還能把多步驟工作交給 Spark
今日 AI 工具|2026/07/28:OpenAI Presence,把客服 AI 從回答問題升級成能查資料、完成核准操作與轉交真人