以前讲:
AI Voice Agent,
画面通常很简单。
你对着:
电话。
App。
智能音箱
说话。
AI 回你:
一个声音。
现在 Google 想再往前一步。
不只:
让 AI 说话。
而是:
让你看到一个正在和你说话的 AI。
Google 9 月 24 日正式推出:
Gemini 3.8 Live with Live Avatar。
它把:
实时语音。
实时视觉理解。
虚拟人物。
后端 Agent Workflow
放进:
同一个实时对话体验。
最适合的场景不是:
「帮我写一篇文章。」
而是:
需要人一直交互的工作。
例如:
客服。
旅馆柜台。
展场导览。
教育。
产品咨询。
远程协助。
先搞懂:Live Avatar 不是普通 AI 生视频
这点很重要。
一般 AI Avatar 工具:
可能是你先输入:
一段 Script。
再等 AI:
生成一段视频。
Gemini 3.8 Live with Live Avatar
不是这种工作方式。
它比较像:
实时 Video Call。
你说一句。
Avatar:
实时理解。
实时回答。
嘴型跟着:
AI 产生的声音。
表情也跟着:
Conversation
动态改变。
不是:
先把整段视频做完
再播放。
Google 把它创建在 Gemini 3.8 Live 上
Gemini 3.8 Live
本来就是:
Real-time Conversational Model。
和一般:
文字 Prompt
最大的不同是:
它直接做:
Speech-to-Speech。
也就是:
你说话。
AI 不一定先完整转成文字、
再产文字、
再交给另一套 TTS。
Google 把:
听。
理解。
回答。
说话
放进:
同一个 Live Model。
这也是为什么:
它比较适合:
Continuous Conversation。
Live Avatar 再多加一层「视觉存在」
Google 现在把:
Video Avatar
同步加入。
官方表示:
Live Avatar 可以根据生成语音:
同步:
Lip-sync。
Facial Expression。
Conversation Response。
所以用户不只是:
听到一个 Voice Bot。
而是:
看到一个:
正在对自己说话的数字角色。
而且支持 97 种语言
这是它最适合:
跨国客服
的一个地方。
Google 表示:
Gemini 3.8 Live with Live Avatar
可以:
理解和说:
97 种语言。
而且可以:
Automatic Language Detection。
甚至:
对话中切换语言。
Avatar 的:
嘴型。
表情
仍会跟着改。
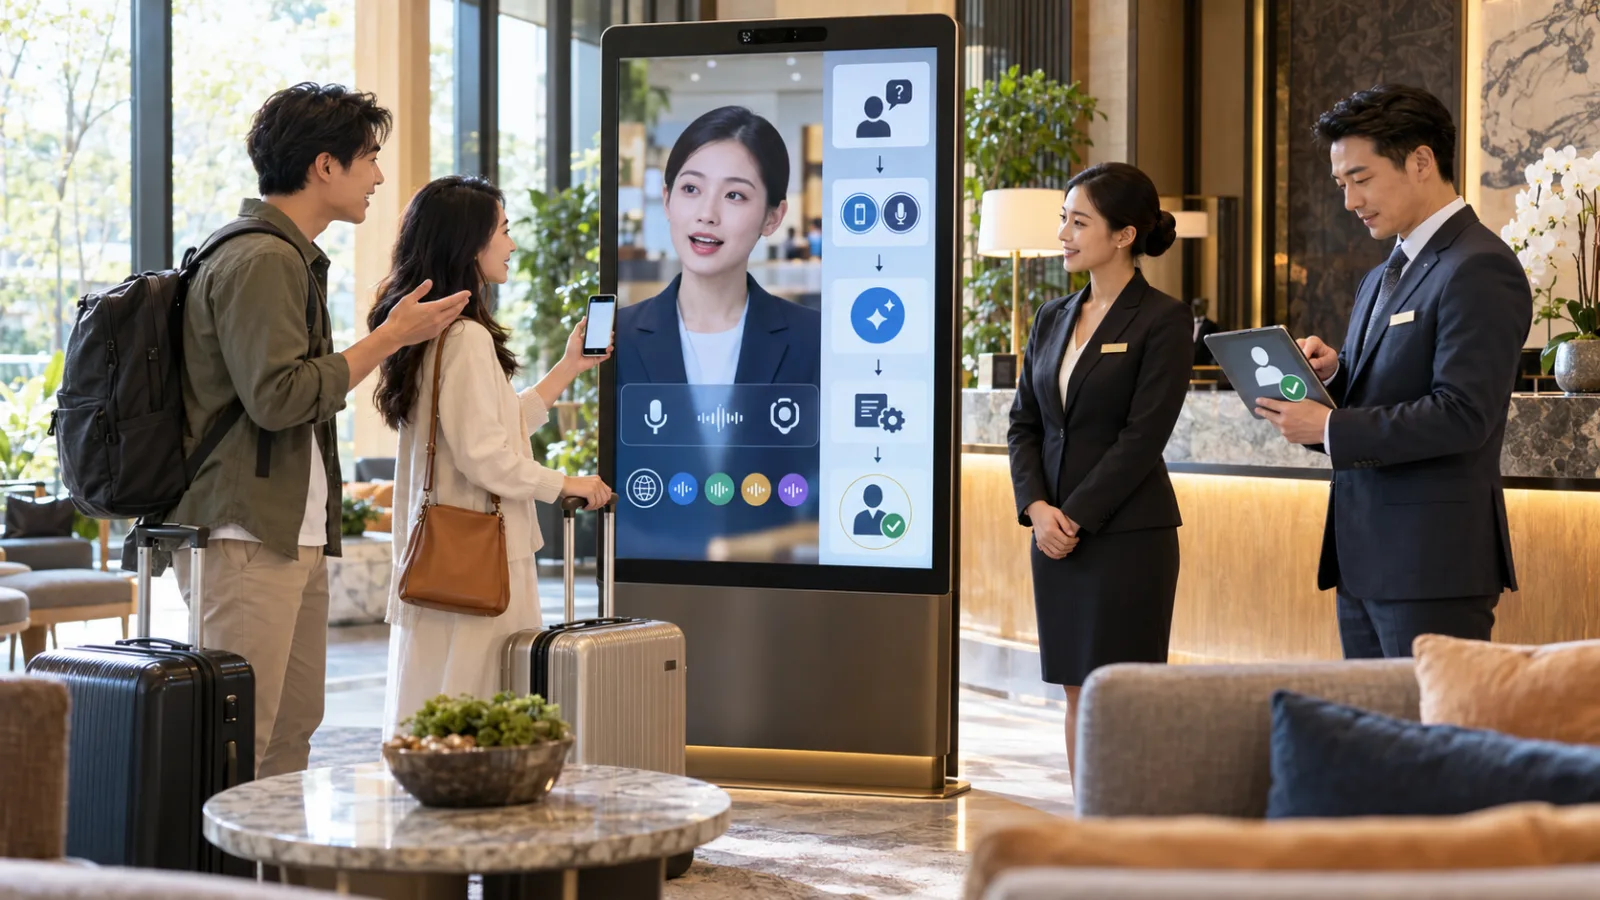
所以假设:
饭店柜台。
第一个客人说:
英文。
第二个:
日文。
第三个:
西班牙文。
理论上:
不需要替每种语言
另外做一套:
预录 Avatar Video。
同一套 Live Agent
可以:
动态切换。
这和传统多语客服成本差很多
以前做:
Digital Human。
如果有:
10 种语言。
常常意味着:
10 套:
语音。
Script。
Recording。
Avatar Content。
更新一次内容:
可能全部重做。
Live Avatar 的方向是:
内容在对话当下生成。
所以企业真正维护的是:
Knowledge。
Rules。
Backend Tools。
Permissions。
不是:
几千支预录像片。
它不只「听」,也能看
这点比 Avatar 外表:
更实用。
Gemini 3.8 Live
支持:
Live Visual Understanding。
也就是可以同时理解:
Camera Feed。
Screen Share。
Audio。
所以用户可以:
边说。
边给 AI 看东西。
例如饭店旅客可以直接把画面给它看
假设客人说:
「我订房数据里是不是含早餐?」
然后:
把手机画面
对着 Camera。
理想 Workflow 可以是:
Avatar:
先理解:
用户正在看的画面。
再搭配:
后端订房数据。
回答:
目前能确认的内容。
如果牵涉:
改房型。
退款。
加价。
付款。
再进:
人工或 Approval Step。
这比:
叫客人把:
订单编号。
姓名。
方案。
日期
全部念一遍,
自然很多。
远程技术支持也可能很适合
例如:
客户不知道:
Router 哪一颗灯有问题。
以前:
客服:
「你看左边第三颗灯。」
客户:
「哪一颗?」
客服:
「不是那个。」
如果 AI 可以:
直接看:
Camera Feed,
用户可以:
把镜头对着设备。
AI:
根据画面
一步一步说:
下一步要看哪里。
注意:
这只是:
适合 Live Visual Understanding
的一种使用情境。
不是说:
Gemini 已经内置每一家 Router
的维修数据。
企业仍然要:
接自己的:
Knowledge Base。
Product Data。
Service Workflow。
Screen Share 更适合软件客服
例如:
客户说:
「我找不到 Export。」
与其:
一来一往描述:
左上角。
右上角。
Settings。
Menu。
如果 Agent:
可以看到:
用户分享的画面,
它就能:
根据:
目前 UI State
直接指导。
这会比:
只听文字描述
少很多:
Context Loss。
真正有趣的其实不是 Avatar,而是「边聊边做」
Google Cloud 对 Gemini 3.8 Live
特别强调:
实时对话期间,
Agent 可以搭配:
Backend Tools。
API。
其他企业系统
完成工作。
而对话:
不用因此完全停下来。
这件事非常关键。
因为传统 Voice Bot:
很容易变成:
客人说一句。
停。
系统查数据。
停。
再回答。
非常不像真人。
Google 想做的是:
例如:
「我帮你查一下。」
Agent:
背景处理。
同时还能:
维持对话 Context。
这才是真正的「Live Agent」
不是:
一个动画人物
在嘴巴动。
而是:
它背后可以:
理解。
查数据。
使用工具。
处理 Workflow。
Avatar:
只是:
把这些能力
变成:
更像面对面交互的入口。
哪些场景最可能先有价值?
第一:Customer Service
适合:
高频。
重复。
但又需要:
语音交互
的问题。
例如:
订单查找。
产品说明。
基本故障排除。
政策解说。
第二:Hospitality/Tourism
饭店。
机场服务。
旅游信息。
展馆。
Visitor Center。
这些地方:
天然就有:
多语需求。
而且很多问题:
重复性很高。
第三:Education
例如:
Virtual Tutor。
学生:
可以用语音问。
甚至:
把画面、
作业、
示意图
给 Agent 看。
Agent:
再实时回应。
但涉及:
评分。
重要教育判断。
仍然要另外设计:
Human Review。
第四:Retail
例如:
店内 Kiosk。
顾客可以:
拿商品给镜头看。
问:
差异。
规格。
用途。
库存。
如果再连:
企业正式商品数据,
就能:
减少:
人工重新查找。
但:
价格。
促销。
库存
仍然应该以:
正式 Backend Data
为准。
不能让模型:
自己猜。
第五:Remote Assistance
特别适合:
「我不知道怎么描述我看到的东西。」
例如:
设备。
软件画面。
产品组装。
操作步骤。
让 Agent:
看到同一个画面,
通常比:
人一直用文字解释
容易很多。
但现在一定要知道:这不是一般 Gemini App 的新按钮
今天如果看到:
Live Avatar
就立刻打开:
Gemini App
找:
「Avatar Mode。」
很可能:
找不到。
因为 Google 现在正式公布的是:
Gemini Enterprise。
以及:
API。
它的主要对象是:
Developer。
Enterprise。
要拿来:
创建自己的:
Customer Service。
Tutor。
Concierge。
Kiosk。
Agent Experience。
不是:
一般消费者今天换一个头像
就能直接视频聊天。
Gemini 3.8 Live 已经是 GA
这一点也要和:
Demo
分清楚。
Google Cloud 已经把:
Gemini 3.8 Live with Live Avatar
列为:
Generally Available。
也就是:
可以拿来:
Production。
不是只有:
Private Research Demo。
目前提供:
US。
EU
Multi-region Endpoint。
支持:
Pay-as-you-go。
也支持:
Provisioned Throughput。
但 Custom Avatar 还没有完全开放
Google 有提供:
Preset Avatar。
也就是:
预先准备好的虚拟人物。
如果企业想做:
自己的品牌角色。
或者:
用一张高品质 Reference Image
创建:
具有指定外观的 Avatar,
目前:
Custom Avatar Creation
仍然需要:
Enterprise Allowlist。
所以不能写成:
「今天所有人都能上传一张照片,立刻做成 Gemini Live Avatar。」
还不是。
而且「可以保留人物外观」会立刻碰到身份问题
Avatar 一旦可以:
从 Reference Image
创建,
最大的风险就是:
假冒真人。
Deepfake。
品牌冒用。
Google 表示:
Live Avatar
针对:
Identity
加入安全设计。
所有 AI 生成的:
Audio。
Video
也会加入:
SynthID。
SynthID
是:
不可见的 AI Watermark。
目的是让:
生成内容
未来更容易被:
辨识。
但 SynthID 不等于「不会被滥用」
这一点和我们以前谈:
AI Image/Video
一样。
Watermark:
是:
Provenance Signal。
不是:
Permission。
不是:
肖像权授权。
也不是:
企业可以随便用任何人的脸。
真正做 Custom Avatar
仍然要确认:
人物授权。
品牌授权。
使用范围。
告知。
数据保存政策。
如果是客服,还要再加一条:不能让 Avatar 外表提高错误可信度
这可能是:
Live Avatar
很容易被忽略的问题。
纯文字 AI:
讲错。
人还比较容易:
怀疑。
一个:
看着你。
点头。
表情自然。
声音流畅。
嘴型同步
的 Avatar:
如果讲错,
反而可能:
更容易让人相信。
所以:
「看起来比较像真人」
不等于:
「答案比较准。」
企业真正要管的:
仍然是:
Grounding。
Knowledge。
Permissions。
Escalation。
客服最重要的不是「像不像真人」
真正 KPI
应该看:
问题有没有解决?
回答正不正确?
第一次解决率多少?
多少必须:
转真人?
高风险 Action
有没有:
正确停下?
客户最后:
有没有少花时间?
如果 Avatar:
做得非常逼真,
但:
一直答错库存。
那只是:
一个很漂亮的错误界面。
导入时最适合先做「低风险+高频」
例如:
营业时间。
基本服务介绍。
场馆方向。
产品操作步骤。
预约流程说明。
订单状态。
这些:
有正式数据。
容易验证。
重复性高。
先测:
Live Agent
到底能不能:
比传统 Voice Bot
更自然地完成。
不要第一天就让它处理:
付款。
退款。
取消订单。
正式合约。
医疗判断。
重大财务决策。
敏感个资修改。
原因不是:
AI Avatar 特别危险。
而是:
这些 Action
本来就应该:
有更强 Approval。
可以先设三层工作
第一层:回答
查:
正式 Knowledge Base。
回答问题。
第二层:准备
帮忙:
填数据。
整理需求。
准备 Action。
第三层:运行
退款。
付款。
取消。
改订单。
正式送出。
第一层:
可以自动化多一点。
越往第三层:
越需要:
Human Approval。
这才是:
企业 Agent
比较合理的设计。
Google 也把 Live Avatar 做成 24 FPS 实时视频
Developer Guide
目前描述:
Gemini 3.8 Live
可直接生成:
同步的:
24 FPS Live Avatar Video。
搭配:
24 kHz Audio。
内核目标是:
Continuous Conversation。
也就是:
不要让 Avatar:
像早期 Digital Human
一样:
说一句。
停。
画面卡一下。
再换下一句。
真正要接近的是:
自然:
插话。
停顿。
转换话题。
继续 Context。
它还会听语气
Gemini 3.8 Live
加入:
Affective Dialogue。
模型可以从:
Prosody。
语气。
停顿。
Speech Inflection
判断:
用户目前的:
情绪与说话状态。
再调整:
Voice Tone。
Conversation Rhythm。
例如:
客人已经很急,
AI 不应该还:
慢慢讲五段背景。
不过:
这仍然是:
模型判断。
不能把它当成:
真正的心理分析。
另外有 Proactive Audio
Google 也加入:
Background Audio Filtering。
模型会尽量区分:
真正对它说的话
和:
旁边的背景声。
这对:
大厅。
展场。
商店。
机场
非常重要。
因为真实环境:
不会像 Demo Room
那么安静。
成本也不能只看「一个 Avatar 多少钱一个月」
这是:
API/Enterprise Tool。
Google Cloud 的计价方式
不是:
固定一个:
「Avatar Pro 每月 20 美元。」
而是:
依:
Text Input。
Image/Video Input。
Audio Input。
Text Output。
Audio Output。
Avatar Video Output
分开计量。
另外也有:
Pay-as-you-go。
Provisioned Throughput。
所以真正做企业项目时,
应该算:
Cost per Completed Conversation。
不是:
只看模型单价。
例如客服真正应该计算:
每次交互:
平均几分钟?
输入多少 Audio?
有没有 Camera Feed?
Avatar Video 开多久?
后端 Tool Call 几次?
最后:
多少问题真的解决?
如果:
一通 AI Avatar 客服
成本比真人便宜,
但:
50% 还是转真人,
就要:
把两边成本
一起算。
所以 Live Avatar 最适合的第一个 Pilot
不要先做:
「取代全部客服。」
先选:
一个:
很窄的问题。
例如:
饭店:
Check-in/设施/早餐说明。
展馆:
动线与展品基本信息。
零售:
产品规格与门市查找。
SaaS:
帐号设置与常见操作。
跑:
100~500 次真实交互。
看:
回答正确率。
平均处理时间。
转真人率。
客户满意度。
每次解决成本。
再决定:
要不要扩大。
Live Avatar 真正重要的地方,不是「AI 终于有一张脸」
AI Avatar:
早就不是新概念。
真正新的是:
以前:
Avatar
是一个:
Presentation Layer。
背后常常只是:
预录 Script。
现在:
Avatar
开始直接长在:
Real-time Agent
上面。
它能:
听。
看。
回答。
维持 Context。
搭配 Backend Workflow。
再透过:
一个视觉角色
和人持续交互。
这才是:
今天最值得注意的地方。
也因此,人机交互会多出一个新问题
以前:
网站 Chatbot
只要让用户知道:
「这是 AI。」
相对简单。
未来一个:
表情自然。
嘴型同步。
声音有情绪。
长得像真人
的数字客服,
企业更需要:
清楚告知:
这不是人类。
哪些信息:
会被收集。
Camera:
有没有开。
Screen:
分享了什么。
对话:
会不会保存。
哪些 Action:
可以自动做。
哪些:
会转真人。
AI 越像真人,
透明度反而越不能降低。
台湾用户今天应该怎么看这个工具?
如果你只是:
一般 Gemini 用户,
今天不用急着找:
Live Avatar 按钮。
它现在不是:
一个大众版滤镜功能。
如果你是:
企业。
开发者。
做:
客服。
教育。
导览。
交互式产品。
真正值得研究的是:
原本只有 Voice/Chat 的流程,有没有哪一步因为「AI 可以看见+有视觉角色」而真的变更好?
如果没有,
根本不用:
硬加 Avatar。
因为画面本身不是 ROI
一个客服问题:
纯 Voice
30 秒解决。
加 Avatar
仍然:
30 秒。
而客户:
也不在意看到脸。
那 Avatar:
可能只是:
增加成本。
但如果场景需要:
创建信任。
示范操作。
看用户画面。
跨语言服务。
长时间交互。
那:
视觉存在
才可能真的:
改变体验。
最后记住一句话
Gemini 3.8 Live with Live Avatar
真正的进步,
不是:
「AI 终于会做一张会动的脸。」
而是:
「实时 Agent 开始同时能听、能看、能说,还能用一个持续存在的视觉角色和人完成工作。」
但越像真人,
越需要把:
身份。
数据。
权限。
转真人条件
讲清楚。
所以今天最值得测的,
不是:
Avatar 到底多逼真。
而是:
它有没有真的让一段原本卡住的人机交互,变得更快、更清楚,而且仍然知道什么时候该把决定权交回给人。
今天,和 AI 一起进步一点。
每天学会一个 AI 技巧。
每天节省一点时间。
每天提升一点能力。
SasaDaily,陪你一起成长。
推荐阅读
今日 AI 工具|2026/08/27:Gemini Live 新版,直接用语音整理 Gmail、听 Daily Brief,还能把多步骤工作交给 Spark
今日 AI 工具|2026/07/28:OpenAI Presence,把客服 AI 从回答问题升级成能查数据、完成核准操作与转交真人