Claude Sonnet 5.5 發布後,有一個數字很容易讓人直接理解錯:
「每件任務最高省 30%。」
那是不是代表:
以前 Claude 一個月花 100 美元,
換成 Sonnet 5.5 後,就會變成 70 美元?
不一定。
因為 Anthropic 並沒有把 Sonnet 的 Token 單價直接打七折。
Sonnet 5.5 的 Token 單價其實沒變
Claude Sonnet 5.5 目前的 API 價格是:
- Input:每百萬 Token 2 美元
- Output:每百萬 Token 10 美元
- Cache Read:每百萬 Token 0.20 美元
這和 Sonnet 5 是一樣的。
所以:
不是同樣用了 100 萬 Token,現在只收你 70%。
Anthropic 說的「最高省 30%」,指的是另外一件事。
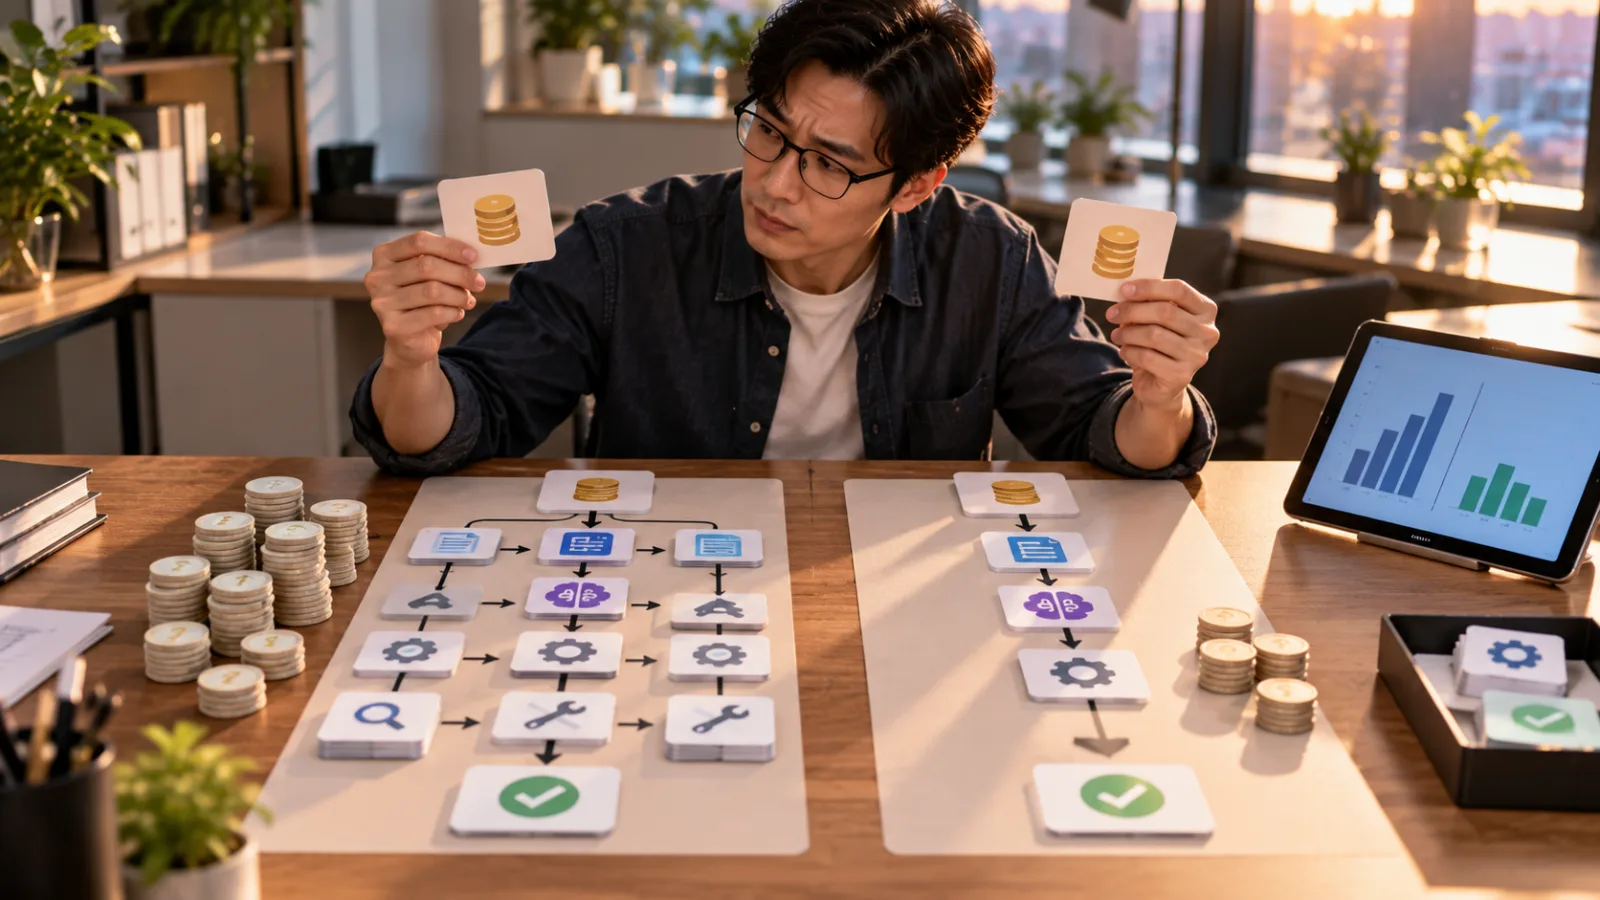
真正省的是:完成同一件事可能用比較少資源
假設以前完成一個工作,需要:
讀很多 Context,
思考很多輪,
呼叫很多次工具,
最後又輸出很長的結果。
Sonnet 5.5 如果可以:
- 更快理解問題
- 少走幾個錯誤步驟
- 少呼叫幾次工具
- 用更少 Token 完成
- 不需要反覆重做
那麼:
雖然每個 Token 價格一樣,最後整件工作的總成本還是會下降。
這才是「Cost per Task」的概念。
用便當來想就很簡單
假設一個零件還是 10 元。
以前完成一個產品需要 10 個零件。
成本就是 100 元。
新版流程只需要 7 個零件。
那就變成 70 元。
不是零件變便宜。
而是:
完成同一件事情需要的零件變少。
Sonnet 5.5 的「最高省 30%」比較接近這種情況。
為什麼每個人省的不會一樣?
因為你的 AI 工作不是固定規格的產品。
同樣叫 Claude 幫忙,
差異可能非常大。
第一個變數:你的工作本來有多複雜?
如果你只是叫 Claude:
「幫我把這三段文字整理成五點。」
原本消耗的資源就不多。
新版模型再有效率,也不一定有很大的絕對差距。
但如果是:
- 長時間 Coding
- 大量文件處理
- Agent 多步驟任務
- 多次 Tool Call
- 長 Context 分析
少掉幾輪執行後,差距就可能更明顯。
第二個變數:Effort 設多高?
Anthropic 現在讓同一個模型使用不同 Effort。
較低 Effort:
模型回答比較快,通常也使用比較少 Token。
較高 Effort:
模型會花更多時間推理與檢查。
Anthropic 官方目前把:
Claude App 與 Claude Code 的預設設成 Medium。
Claude Platform 預設則是 High。
所以即使兩個人都使用 Sonnet 5.5,
一個拿大量簡單任務跑較低 Effort,
另一個每天跑高 Effort 的複雜 Agent,
成本結構本來就不同。
第三個變數:Prompt 有多大?
模型變有效率,
並不代表你送進去的資料會自動縮小。
如果每一次工作都把:
- 幾百頁文件
- 大型 Repository
- 完整聊天紀錄
- 大量工具定義
重新送進去,
Input 成本仍然存在。
因此不能看到「模型省 30%」,
就忽略 Context 本身有多大。
第四個變數:Output 到底有多長?
Output Token 比 Input Token 貴。
Sonnet 5.5 的 Output 目前是:
每百萬 Token 10 美元。
如果你的工作習慣是:
「越完整越好,全部展開寫。」
即使模型內部執行變有效率,
最後輸出仍然很長,
實際成本下降幅度也可能被吃掉。
第五個變數:Agent 做了幾輪?
這對 Coding Agent 特別重要。
你表面上只下了一個指令:
「幫我修這個 Bug。」
背後可能其實跑了:
搜尋檔案 → 看 Code → 執行測試 → 修改 → 再測 → 發現問題 → 再修改。
Anthropic 表示,早期測試裡 Sonnet 5.5 比 Sonnet 5 更常把 Tool Call 批次處理,因此可能用較少步驟完成。
這才是 Agent 工作真正可能省錢的地方。
不是:
一個 Tool Call 變便宜 30%。
而是:
原本可能要 10 次,現在更少次就做完。
第六個變數:Cache 有沒有真的用到?
如果你每天重複讓 Claude 讀:
相同的公司規則、
相同的大型 Codebase、
相同工具定義,
Prompt Cache 可以讓部分重複 Context 用較低價格讀取。
但 Cache Hit 很高,也不能單獨代表總成本一定低。
因為帳單仍然還有:
- 新 Input
- Output
- Cache Write
- Tool 執行
- 多輪 Agent 工作
所以「模型效率」和「你的 Workflow 效率」其實是兩件事。
Anthropic 自己公布的企業測試也不是人人剛好 30%
這一點很重要。
Anthropic 公開的 Early Tester 結果,本身就能看出差異。
Slack 表示,在自己的離線測試裡,Sonnet 5.5 比 Sonnet 5 使用約 14% 更少 Output Token。
Box 表示,自己的測試中總 Token 大約少 12%。
另一個金融工作測試裡,Balyasny Asset Management 則觀察到更大的 Token 差距。
這些都不是矛盾。
反而說明:
成本改善幅度和工作內容有關。
所以「最高 30%」不能改寫成:
「所有使用者固定省 30%。」
那要怎麼知道自己到底有沒有省?
最實際的方法不是猜。
拿你自己的工作比。
例如選 20 個真的會做的任務:
- 5 個簡單整理
- 5 個文件工作
- 5 個 Coding 任務
- 5 個較複雜 Agent 工作
然後比較:
1. 有沒有完成?
便宜但做錯,不算省。
2. 總 Token
不要只看 Input Token。
Input、Output、Cache 都要算。
3. Tool/Agent 執行次數
新版是不是更少繞路?
4. 人工修改時間
模型少花 20%,結果卻多花半小時人工修正,也不划算。
5. Cost per Successful Task
最後才算:
真正完成一件可用工作,到底多少錢?
這才是最重要的數字。
所以答案是什麼?
Claude Sonnet 5.5 的確可能讓很多工作變便宜。
但原因不是:
Token 單價直接降 30%。
而是:
同一件工作可能用更少 Token、更少步驟、更少 Tool Call 完成。
最後你的實際成本到底少:
5%?
15%?
30%?
甚至某些工作幾乎沒有差?
要看你的真實 Workflow。
所以看到 AI 公司寫:
「最高省 30%」
下一個問題不要只問:
「便宜多少?」
而應該問:
「它是把單價降了,還是把完成一件工作的用量降了?」
這兩件事,差非常多。
推薦閱讀
AI 一分鐘教學|2026/09/23:Claude Code 跑完別只看答案,輸入 /usage 用「Cache/Output/Turns」找出哪裡在燒錢
AI 快問快答|2026/09/02:Claude Prompt Cache Hit 很高,就代表這個 AI 工作一定比較便宜嗎?