Data agent 最容易讓人產生一個錯覺:
只要直接問問題,AI 就會自己找到正確答案。
例如:
「為什麼這個月業績變差?」
看起來很合理。
但這句話其實藏了很多沒有說清楚的東西。
什麼叫:
業績?
這個月:
和哪一個月比?
全部客戶一起看?
還是:
新客戶。
舊客戶。
地區。
商品。
通路。
分開看?
最後找到可能原因後:
只是整理給你看?
還是:
可以直接通知團隊。
改 Campaign。
建立 Follow-up?
如果這些沒有先說:
AI 仍然可能做出:
非常完整的分析。
問題只是:
它回答的可能不是你真正想問的問題。
所以今天只學一個方法。
在用 Data agent 分析以前:
先寫一張:
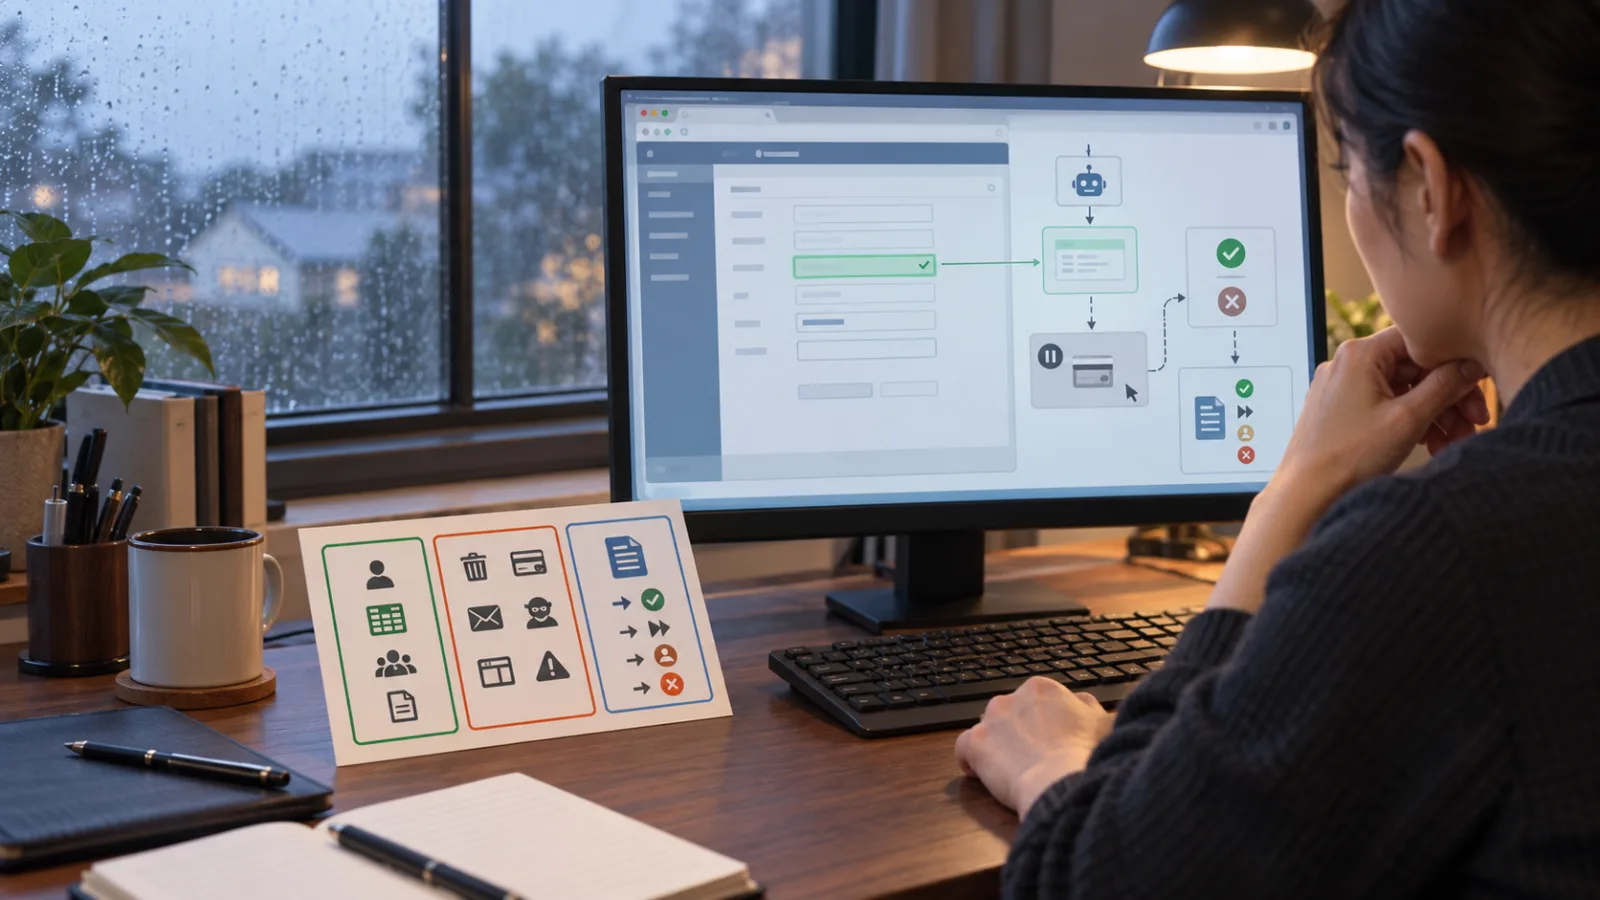
四格分析卡。
四格只有:
指標。
期間。
分群。
先不要行動。
第一格:先定義「你到底在看哪一個數字」
假設你問:
「為什麼 Revenue 掉了?」
第一個問題不是:
為什麼?
而是:
你公司的 Revenue 到底怎麼算?
可能是:
訂單建立金額。
付款完成金額。
扣退款前。
扣退款後。
含稅。
未稅。
會計認列收入。
不同公司:
可以完全不同。
如果沒有先固定 Definition:
AI 很可能使用:
它找到的某個合理欄位。
但那個欄位:
不一定是公司正式 KPI。
同一個「營收」,甚至不同部門可能說的是不同東西
Sales:
可能看:
簽約金額。
Finance:
看:
認列收入。
E-commerce:
看:
Completed Order。
Marketing:
看:
Campaign Attribution Revenue。
四個數字:
可能都叫:
Revenue。
所以分析以前:
最好直接指定:
「Revenue 請使用公司正式 Semantic Layer 裡的 Net Revenue Definition。」
如果公司沒有 Semantic Layer:
至少說清楚:
要用哪份:
Dashboard。
Report。
Spreadsheet。
作為定義來源。
Data agent 本身就支援 Business Definition
這也是今天這個工具特別值得看的地方。
OpenAI 對 Data agent 的設計:
不是只讓 AI:
看到一堆 Table。
它還可以使用:
企業本身的:
Metric Definition。
Custom Calculation。
資料關係。
以及:
Semantic Layer。
意思是:
公司如果已經把:
「什麼叫 Active Customer?」
「什麼叫 Churn?」
「什麼叫 Qualified Lead?」
定義清楚:
AI 可以沿用。
但前提仍然是:
你知道:
這次應該用哪一個定義。
所以第一格可以很短
例如:
指標:Net Revenue,依 Finance 正式定義,扣除 Refund。
或:
指標:Customer Retention,使用公司既有 Retention Dashboard Definition。
不用寫一大篇。
只要:
把模糊名詞變成:
可以驗證的名詞。
第二格:和哪一段時間比較?
很多錯誤分析:
其實不是數字算錯。
而是:
比較方式有問題。
例如你看到:
這週營收:
比上週低。
AI可能說:
下降。
但上週剛好:
有大型促銷。
那這個比較:
本來就不公平。
又例如:
星期一到星期三:
拿去和:
上週完整七天相比。
數字一定很難看。
所以第二格只問:你到底要和誰比?
例如:
本月 vs 上月。
本季 vs 上季。
今年 9 月 vs 去年 9 月。
最近七天 vs 前七天。
活動期間 vs 同長度 Base Period。
不同問題:
需要不同比較方式。
不要只說:
「最近。」
或:
「之前。」
季節性產業更要小心
例如:
月餅。
旅遊。
開學用品。
冷氣。
年菜。
你拿:
9 月。
和:
8 月。
比較:
可能得到很大的變化。
但真正合理的基準:
可能是:
去年同期。
因為:
季節本來就不同。
AI 不一定知道:
你這個生意的季節性。
所以期間:
不要讓它完全自己猜。
第三格:要拆哪些分群?
假設:
Revenue 的確下降 10%。
這個 Total:
本身還沒有太多行動價值。
真正要問:
是哪裡掉?
例如:
台北掉。
台南沒掉。
或者:
新客戶沒掉。
舊客戶掉。
或者:
實體店沒掉。
Online 掉。
或者:
A Product 沒問題。
B Product 掉很多。
這就是:
Segment。
分群是把「整體問題」變成「可以處理的問題」
一句:
「營收下降。」
很難行動。
但如果變成:
「營收下降主要集中在南區既有客戶的 B 產品。」
下一步:
就清楚很多。
可以再查:
價格?
庫存?
配送?
競爭?
客服?
產品問題?
所以 Data agent 的價值:
不只是告訴你:
Total Changed。
而是:
一路往下拆。
但也不要一開始拆 30 個維度
如果你一開始就叫 AI:
按:
地區。
年齡。
產品。
通路。
會員等級。
性別。
活動。
業務。
付款方式。
裝置。
全部交叉分析。
很容易得到:
一大堆:
看起來很有洞察。
但其實只是:
隨機波動的小群體。
所以第一次:
先選:
兩到三個最可能有意義的 Segment。
例如:
Region。
Customer Type。
Product Line。
夠了。
第四格:先不要行動
這格很容易被忽略。
Data agent 不只是:
可以分析。
它未來還可能:
把 Finding:
送進 Slack。
Email。
或透過已連接工具:
執行經批准的 Action。
這是優點。
但第一次分析時:
不要讓:
Finding
直接變成:
Action。
因為「可能原因」還不是「已證明原因」
例如 AI 分析:
發現:
Retention 下降。
同時:
Support Ticket 增加。
於是提出:
「客服問題可能影響留存。」
這是一個:
Hypothesis。
不是:
已證明因果。
如果下一步直接:
通知整個客服部:
「你們造成客戶流失。」
那就太快了。
所以第四格可以直接寫:
「這一輪只分析與提出下一個驗證,不要傳訊息、改資料或執行任何外部 Action。」
這一句:
非常有用。
整張四格卡可以直接長這樣
假設你今天想知道:
為什麼這個月續約率下降。
可以直接寫:
請分析本月 Customer Retention 的變化。

【指標】
使用公司正式 Semantic Layer 中的 Customer Retention 定義。
不要自行改用其他相似指標。

【期間】
比較本月至今,與上月相同天數。
如果有明顯季節性,再補充去年同期作為第二組比較。

【分群】
先拆:
1. Region
2. New vs Existing Customer
3. Product Line

先不要自行擴充其他分群,除非你先說明理由。

【先不要行動】
這一輪只做分析。
不要寄 Email、發 Slack、修改 Dashboard Source、建立 Campaign 或執行任何外部 Action。

請先告訴我:
- 使用了哪些資料來源
- 使用的指標定義
- 最主要的變化集中在哪裡
- 哪些是已確認事實
- 哪些只是可能原因
- 下一步最值得驗證什麼
這就是:
四格分析卡。
為什麼不是直接問:「為什麼留存下降?」
因為:
「為什麼」是一個很大的問題。
AI 可能需要自己決定:
Metric。
Period。
Comparison。
Segment。
Source。
如果五個地方:
每個都自己猜一次。
最後即使分析很漂亮:
你也很難知道:
錯誤到底從哪裡開始。
先定義四格,其實是在降低 Investigation Space
Data agent 很強的一點是:
可以:
一路 Drill Down。
問 Follow-up。
比較群體。
查看 Evidence。
但:
能查很多。
不代表:
第一輪應該什麼都查。
越少的:
明確假設。
越容易:
驗證。
這和一般 AI Agent 一樣。
不是:
能力越強。
Prompt 就越模糊。
反而更需要:
清楚目標。
第一次結果出來後,再往下追
例如 AI 回報:
Retention 下降:
主要集中在:
Existing Customer。
東區。
某一個 Product Line。
這時:
才開始第二輪。
問:
這群客戶最近:
Support Ticket 有沒有增加?
Price 有沒有改?
Delivery Time 有沒有拉長?
Product Version 有沒有改?
每一步:
都從上一個 Evidence:
往下走。
這就叫:
Investigation。
不是:
一次要求 AI:
「幫我找到真正原因。」
Data agent 可以在同一段 Conversation 裡持續追
這個設計非常適合這種工作。
第一輪:
找到:
哪裡變了。
第二輪:
拆 Segment。
第三輪:
查可能 Driver。
第四輪:
比較 Evidence。
最後:
才形成:
比較可信的 Finding。
不需要:
每問一次。
重新做一份 Report。
但每一輪都要留意 Definition 有沒有偷偷改掉
例如:
第一輪:
你看的是:
Net Revenue。
第二輪 AI 為了補充資料:
突然引用:
Gross Sales。
如果沒有注意:
兩個 Chart:
看起來可以放在一起。
其實:
不是同一個東西。
所以 OpenAI 自己的使用指南也特別提醒:
使用者要確認:
Source。
Time Period。
Filter。
Metric Definition。
這四項:
和今天這張分析卡:
其實非常接近。
如果 AI 的結果和公司原本 Dashboard 不一樣,先不要問誰對
先比:
Definition。
例如:
Data agent:
Retention 82%。
正式 Dashboard:
78%。
不要立刻說:
AI 算錯。
也不要立刻說:
舊 Dashboard 錯。
先問:
兩邊使用:
同一個 Metric Definition 嗎?
同一個 Period 嗎?
同一個 Filter 嗎?
同一個 Customer Population 嗎?
很多「數字不一致」:
最後只是:
條件不一樣。
這也是為什麼 Source 很重要
Data agent 能連:
Data Warehouse。
Drive。
SharePoint。
BI。
資料很多。
但:
資料多:
不等於:
每一份都同樣正式。
可能有:
草稿 Spreadsheet。
正式 Finance Report。
舊 Dashboard。
新版 Dashboard。
測試資料。
所以企業如果有:
Source of Truth:
最好明確告訴 AI:
優先使用哪個。
小公司也可以用同一個方法
不一定要有:
Snowflake。
BigQuery。
Data Team。
才可以理解這個技巧。
假設你只有:
Google Sheets。
也一樣。
不要問:
「最近 Facebook 表現怎樣?」
可以改成:
指標:
Website Click。
期間:
最近七天 vs 前七天。
分群:
貼文類型+是否真人出鏡。
先不要行動:
不要直接改廣告或排程。
先:
整理事實。
再:
提出可能原因。
一樣成立。
這和 8 月我們做 Meta AI 教學的差別在哪?
當時教的是:
看到 AI 分析後:
把結果分成:
事實。
推測。
下一個測試。
那是在:
分析完成之後
避免把相關性:
誤認成因果。
今天教的則是在:
分析開始之前
先固定:
指標。
期間。
分群。
行動邊界。
兩個方法:
剛好可以接在一起。
完整流程其實只有六步
第一:
寫四格分析卡。
第二:
讓 Data agent 找資料。
第三:
確認 Definition、Period、Filter、Source。
第四:
找出變化最大的 Segment。
第五:
把結果分:
Fact/Hypothesis。
第六:
決定下一個驗證。
這時才考慮:
要不要:
通知人。
做 Dashboard。
改 Campaign。
調整 Workflow。
不要讓 Dashboard 的精緻程度騙到你
Data agent 可以:
快速建立:
漂亮。
可互動。
可分享。
的 Dashboard。
但圖表越漂亮:
人越容易:
相信它。
這其實也是風險。
Chart:
只是:
一種呈現方式。
真正應該先確認:
數字:
怎麼算?
資料:
從哪裡來?
比較:
公平嗎?
Sample:
夠嗎?
原因:
真的有證據嗎?
Dashboard:
最後才是包裝。
如果只是做內部探索,可以快一點
例如:
想找:
哪個 Product 最近值得注意。
先讓 AI:
快速探索。
沒關係。
但如果結果要:
進:
董事會。
正式財報。
人事決策。
價格調整。
客戶承諾。
就要:
提高 Verification Level。
同一個 Data agent:
可以用在:
不同風險層級。
不能全部用:
同一套 Review。
「先不要行動」不是要把 Agent 變笨
有些人會想:
既然 Data agent 可以:
Analysis → Action。
為什麼還要故意停?
因為:
第一次找原因:
最有價值的不是:
快。
而是:
確定方向沒有錯。
等某個分析:
已經跑了十次。
Definition 穩定。
Dashboard 穩定。
Action 也有明確規則。
再考慮:
把低風險下一步:
接起來。
這才是:
Workflow Automation。
例如每週營運報告可以逐步自動化
第一週:
AI 分析。
人全部 Review。
第二階段:
固定四格。
固定 Dashboard。
人看 Exception。
第三階段:
如果某個指標:
超過已定 Threshold。
才準備:
Slack Draft。
但不送。
再成熟:
才考慮:
經批准後自動通知。
這比:
第一天就說:
「每週幫我分析完自動通知所有人。」
安全很多。
這也是 AI 工作流程診斷真正值得看的地方
很多人以為:
工作流程診斷就是:
找:
「哪一個工作可以全部自動化?」
其實更實際的是:
先找:
哪一步:
重複。
規則清楚。
資料來源明確。
做錯可以驗證。
然後:
只把那一段:
先交給 AI。
Data Analysis:
也是一樣。
先自動:
取數。
比較。
分群。
整理 Evidence。
再把:
原因判斷。
商業決策。
真正 Action。
留給人。
如果公司每週都在重複做同一份分析,就更值得拆
例如:
每週一:
行政匯出資料。
Analyst 清理。
業務主管問原因。
Analyst 再切 Segment。
重新畫圖。
再寄給團隊。
如果每週流程:
幾乎相同。
真正可以先交給 AI 的:
可能不是:
「替主管做決策。」
而是:
前面:
找資料。
跑固定比較。
找異常 Segment。
更新 Dashboard。
整理待確認問題。
人只處理:
這次哪一個變化真的值得行動。
所以今天不要先學十個 Data agent 指令
只記住四格:
指標
這個數字到底怎麼算?
期間
到底和哪一段時間比?
分群
要拆哪幾個真正有意義的群體?
先不要行動
第一輪只分析。
不要直接把可能原因:
變成真正商業動作。
把這四格寫清楚:
你其實已經先完成:
一半的分析品質控制。
因為最危險的不是:
AI 不會算。
而是:
它把一個模糊問題,算得非常精確。
如果你也想知道自己的工作裡,哪一步最適合先交給 AI,留言「流程」,我可以先幫你看看從哪一步開始。
今天,和 AI 一起進步一點。
每天學會一個 AI 技巧。
每天節省一點時間。
每天提升一點能力。
SasaDaily,陪你一起成長。
推薦閱讀
AI 一分鐘教學|2026/07/31:請 AI 分析資料時,要求它留下「資料來源、處理步驟、重現方式」
AI 一分鐘教學|2026/08/25:用 Meta AI 看社群成效後,先分成「事實、推測、下一個測試」
AI 快問快答|2026/08/25:Meta AI 已經讀到 Facebook/Instagram 真實數據,就代表它分析出的「原因」一定是真的嗎?