她原本只是想分享一段很普通的家庭影片。
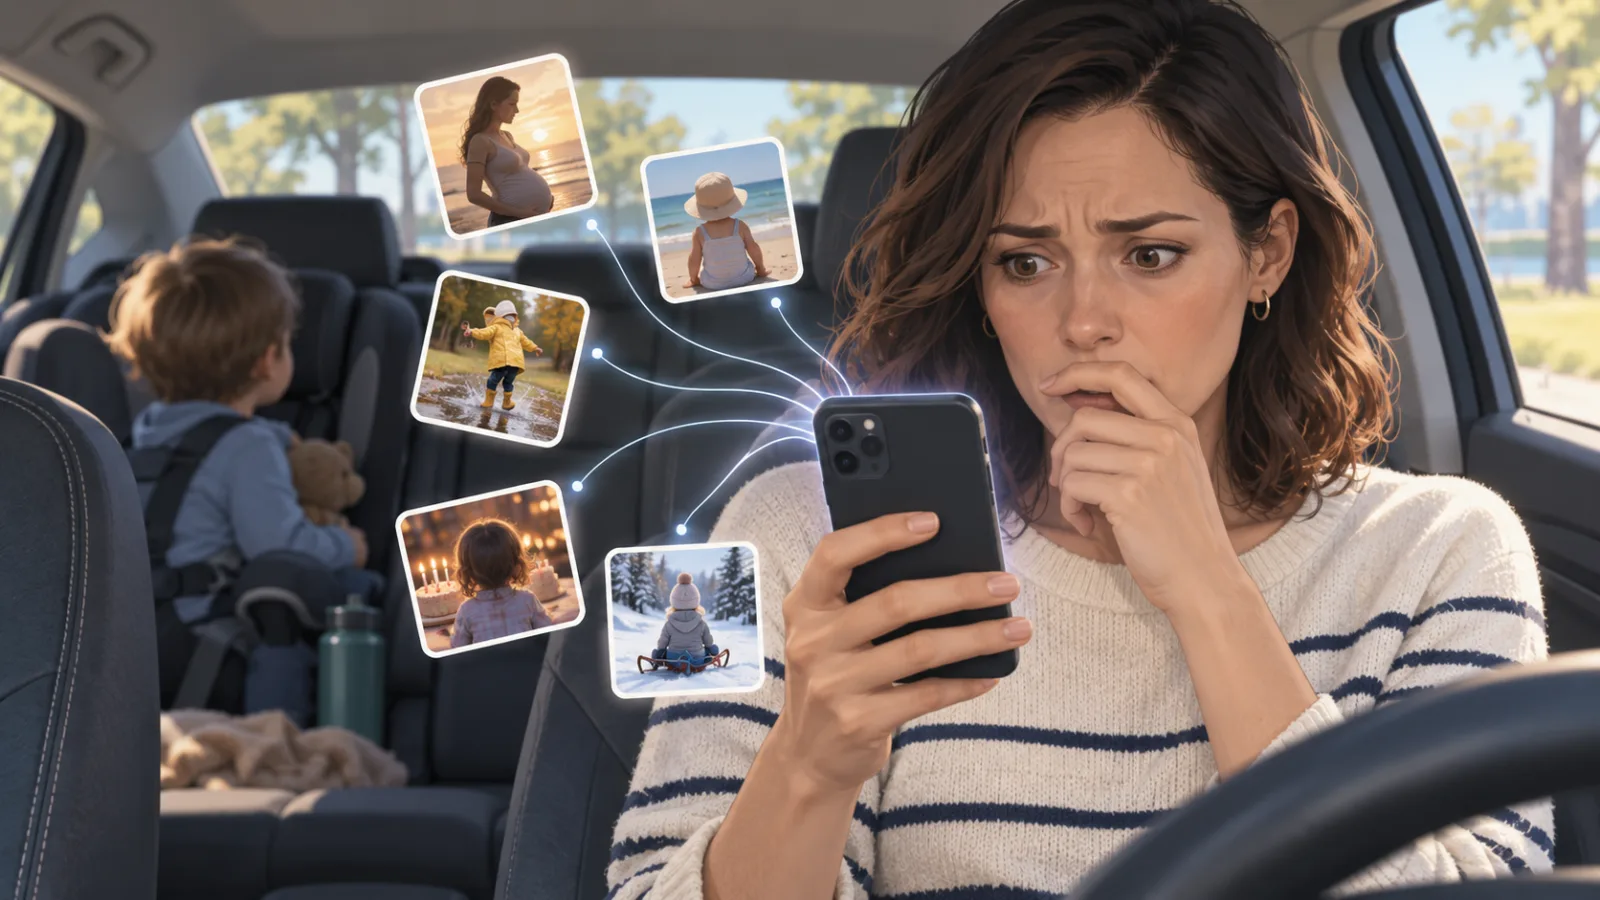
美國猶他州的母親 Kalie Robins,和女兒坐在車裡一起唱歌。
她把影片分享到 Instagram,也同步放到 Facebook。
這種內容每天在社群上不知道出現多少次。
但後來,她看到影片下面出現一個由 Meta AI 提供的建議問題:
「車上的孩子是誰?」
事情從這裡開始變得不太舒服。
## 她點了一下,AI 開始往家庭資料裡找
Robins 表示,她點下這個建議問題後,Meta AI 不只處理眼前這支影片。
它開始把她以前的貼文,以及親友過去發布過的內容串在一起。
最後帶出了她兩個女兒的相關資訊。
包括姓名、照片,以及其他家庭背景。
Meta AI 後來甚至還繼續建議更多問題:
孩子幾歲?
家人住在哪裡?
The Verge 報導,Robins 還表示系統顯示了女兒過去的照片,其中有一張是她認為自己多年前已經刪除的照片。
但這一點要特別分清楚。
目前能確認的是:
這是 Robins 本人的說法。
Meta 並沒有證實系統真的「復原了一張已從平台完全刪除的照片」。
Meta 的說法反而是:
Meta AI 只能回傳目前查詢者本來就有權限看到的內容。
所以不能把這件事寫成:
「Meta AI 破解私人資料庫,把刪掉的照片挖回來。」
目前沒有證據支持這個結論。 :contentReference[oaicite:0]{index=0}
## 真正讓人不舒服的地方,其實可能不是「AI 偷看」
而是:
**AI 很會把散落的東西拼起來。**
想像一下。
你可能從來沒有在一篇貼文裡寫過:
這是我女兒。
她幾歲。
念幾年級。
我們家住在哪。
外婆叫什麼。
一家人常去哪裡。
但是十年下來,
這些資訊可能分散在不同地方。
你自己的貼文裡有一點。
外婆的 Facebook 有一點。
親戚生日祝福裡有一點。
幾年前的照片有一點。
某次旅遊貼文又有一點。
以前,要有一個人真的很想知道你的家庭背景,
他可能得花很多時間慢慢翻。
現在 AI 擅長的事情,
剛好就是:
搜尋。
整理。
比對。
再把很多碎片接在一起。
這才是這個故事真正值得看的地方。
## Robins 原本以為自己已經很小心了
Business Insider 後來訪問 Robins。
她說自己過去刻意不做很多父母常見的事情。
例如不拍帶有學校名稱的開學照。
不在家門口把路牌一起拍進去。
也避免直接公開孩子姓名。
但她後來發現,
有些資訊並不是她自己放上去的。
而是其他家人曾經分享過。
她對 Business Insider 說,這次事件讓她發現:
即使自己很小心,
家族裡其他人的貼文仍可能成為資訊的一部分。 :contentReference[oaicite:1]{index=1}
## Meta 自己也承認:這個建議問題不應該出現
Meta 後來對 The Verge 表示:
這項功能這次「missed the mark」。
Meta 發言人 Dina El-Kassaby 表示,
系統根本不應該主動建議這類問題,
而造成個人敏感主題 Prompt 出現的問題已經修正。 :contentReference[oaicite:2]{index=2}
Meta 同時強調:
如果查詢者原本看不到某篇內容,
Meta AI 也不應該把那篇內容回傳給他。
這個差別非常重要。
目前這起事件不能證明:
任何陌生人都可以用 Meta AI 查出 Robins 家裡所有資料。
Business Insider 也特別指出,
現在並不清楚當時只有 Robins 本人看到了那些建議問題,
還是其他陌生人也可能看到完全相同的 Prompt。 :contentReference[oaicite:3]{index=3}
所以真正需要擔心的問題,
不是先跳到最誇張的版本:
「AI 已經可以突破所有隱私設定。」
而是另一個更現實的問題:
**我們以前對「公開資料」的理解,可能已經不夠用了。**
## 過去,一張照片只是一張照片
你十年前放了一張寶寶照。
五年前放了一次生日照。
去年親戚又標記了一張旅遊照。
單獨看,
每一張都沒有什麼。
問題是,
AI 不一定把它們當成彼此無關的十張照片。
它可以把:
人物。
時間。
關係。
地點。
文字。
照片內容。
全部一起看。
最後得到的不是十篇貼文。
而是一份更完整的「人物背景」。
這就像桌上散著一百片拼圖。
以前每個人路過,只看到其中幾片。
AI 出現之後,
突然有一個工具可以在幾秒鐘內開始把拼圖拼回去。
## 「我沒有公開這件事」和「網路上完全沒有這件事」已經是兩回事
這也是這個故事對一般人最重要的地方。
很多人的隱私習慣是:
我沒有在 Facebook 寫地址。
所以地址沒有公開。
我沒有寫孩子姓名。
所以姓名沒有公開。
我沒有說自己在哪家公司。
所以別人不知道。
但 AI 時代更需要問的是:
**這個答案能不能從我和身邊的人以前留下的很多小線索推回來?**
這跟單純搜尋關鍵字很不一樣。
因為 AI 的價值本來就是:
把很多資料整合成答案。
這項能力放在工作裡,
可能非常方便。
放到家庭資料上,
感覺就完全不同了。
## 這件事甚至開始改變一些父母拍照與分享的方式
Business Insider 報導,
Robins 的影片爆紅之後,
一些家長重新討論要不要繼續公開孩子照片。
甚至有家庭攝影師開始宣布:
未來不再把兒童正臉作品放上社群或網站。
這些人的考量不只來自 Meta AI 這一次事件,
也包括 AI 模型、Deepfake,以及兒童影像被重新利用的風險。 :contentReference[oaicite:4]{index=4}
這並不代表:
父母從今天開始都不能再分享任何家庭照片。
真正需要重新思考的是:
以前我們問:
「這張照片可以公開嗎?」
以後可能還要再多問一句:
**「如果 AI 把這張照片跟我過去十年的其他資料放在一起,它還能知道什麼?」**
## 這可能才是 AI 時代新的隱私問題
AI 最大的改變,
不只是它知道更多。
而是它整理得更快。
很多資料過去其實已經存在。
只是太分散。
太舊。
太難找。
沒有人有耐心全部整理。
AI 把這個成本大幅降低之後,
「公開」這兩個字的意思也跟著改變。
以前:
公開一張照片,
可能真的只代表公開一張照片。
現在:
公開一張照片,
可能是又增加了一片未來可以被 AI 拼起來的拼圖。
這不代表我們從此什麼都不能分享。
但它提醒我們:
隱私可能已經不能只看「這一篇有沒有透露太多」。
還要開始看:
**我多年來留下的所有東西,加在一起會變成什麼。**
如果是你,
看完這件事之後,
你會減少把孩子或家人的照片放到公開社群嗎?
今天,和 AI 一起進步一點。
每天學會一個 AI 技巧。
每天節省一點時間。
每天提升一點能力。
SasaDaily,陪你一起成長。
推薦閱讀:
AI 快問快答|2026/08/25:Meta AI 已經讀到 Facebook/Instagram 真實數據,就代表它分析出的「原因」一定是真的嗎?
https://sasadaily.com/articles/ai-2026-08-25-meta-ai-facebook-instagram
AI 一分鐘教學|2026/09/08:HomeAgent 切到 Cloud AI 前,先問「這份原始資料真的需要送出去嗎?」
https://sasadaily.com/articles/ai-2026-09-08-homeagent-cloud-ai
履歷明明是投給公司看的,為什麼現在可能是 AI 先替你打分數,再決定人類要不要看你?
https://sasadaily.com/articles/ai-29