她原本只是想分享一段很普通的家庭视频。
美国犹他州的母亲 Kalie Robins,和女儿坐在车里一起唱歌。
她把视频分享到 Instagram,也同步放到 Facebook。
这种内容每天在社区上不知道出现多少次。
但后来,她看到视频下面出现一个由 Meta AI 提供的建议问题:
「车上的孩子是谁?」
事情从这里开始变得不太舒服。
## 她点了一下,AI 开始往家庭数据里找
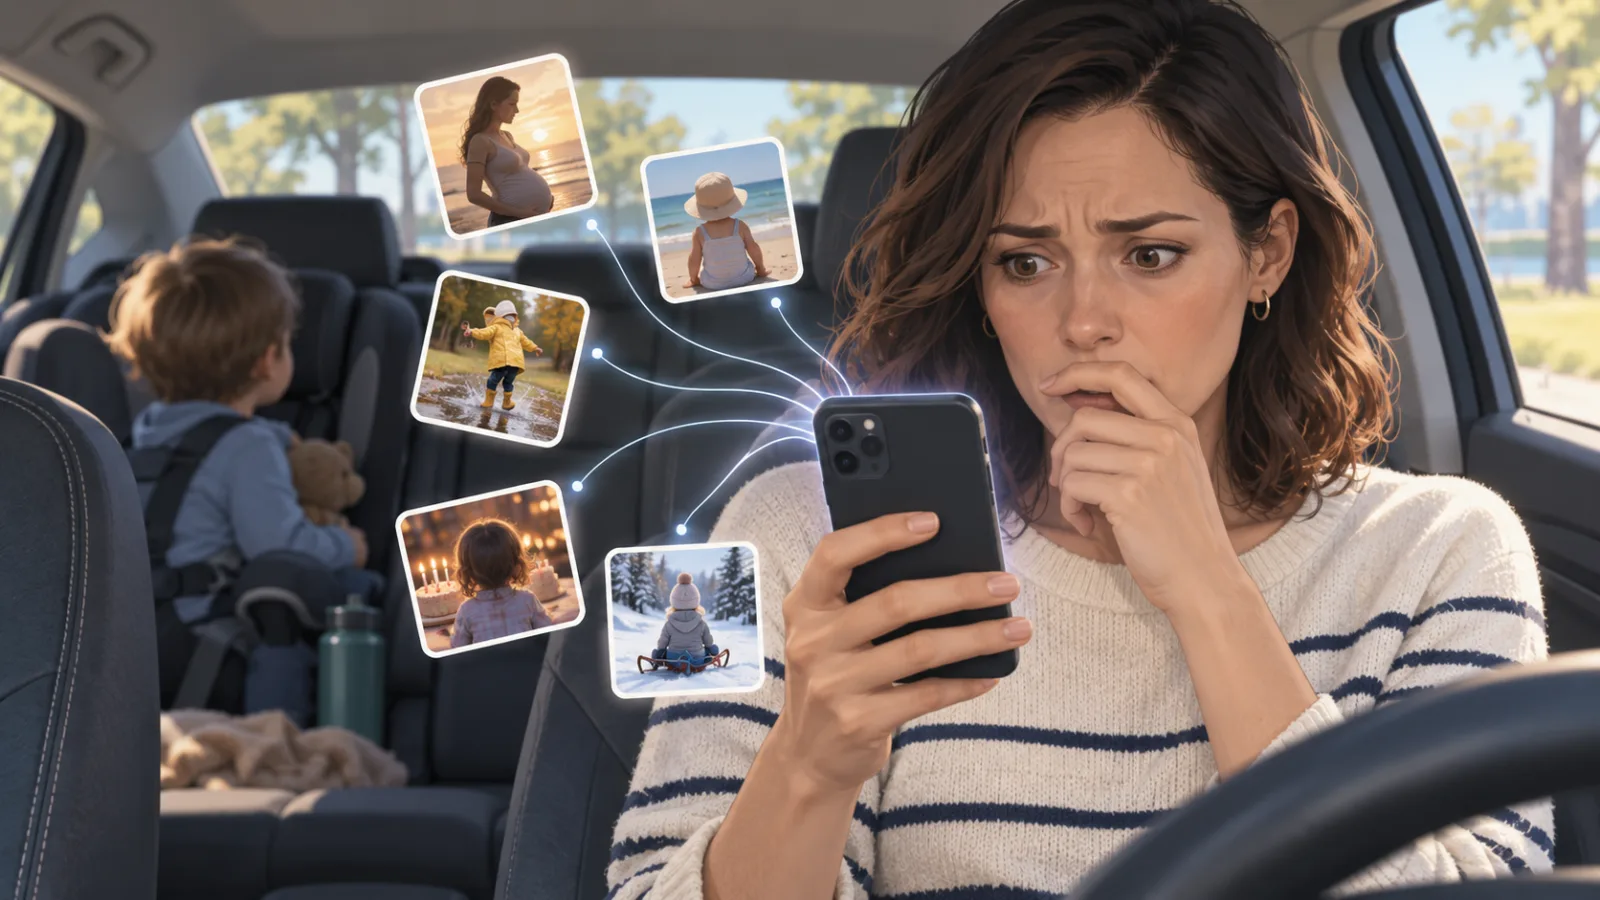
Robins 表示,她点下这个建议问题后,Meta AI 不只处理眼前这支视频。
它开始把她以前的贴文,以及亲友过去发布过的内容串在一起。
最后带出了她两个女儿的相关信息。
包括姓名、照片,以及其他家庭背景。
Meta AI 后来甚至还继续建议更多问题:
孩子几岁?
家人住在哪里?
The Verge 报导,Robins 还表示系统显示了女儿过去的照片,其中有一张是她认为自己多年前已经删除的照片。
但这一点要特别分清楚。
目前能确认的是:
这是 Robins 本人的说法。
Meta 并没有证实系统真的「复原了一张已从平台完全删除的照片」。
Meta 的说法反而是:
Meta AI 只能回传目前查找者本来就有权限看到的内容。
所以不能把这件事写成:
「Meta AI 破解私人数据库,把删掉的照片挖回来。」
目前没有证据支持这个结论。 :contentReference[oaicite:0]{index=0}
## 真正让人不舒服的地方,其实可能不是「AI 偷看」
而是:
**AI 很会把散落的东西拼起来。**
想像一下。
你可能从来没有在一篇贴文里写过:
这是我女儿。
她几岁。
念几年级。
我们家住在哪。
外婆叫什么。
一家人常去哪里。
但是十年下来,
这些信息可能分散在不同地方。
你自己的贴文里有一点。
外婆的 Facebook 有一点。
亲戚生日祝福里有一点。
几年前的照片有一点。
某次旅游贴文又有一点。
以前,要有一个人真的很想知道你的家庭背景,
他可能得花很多时间慢慢翻。
现在 AI 擅长的事情,
刚好就是:
搜索。
整理。
比对。
再把很多碎片接在一起。
这才是这个故事真正值得看的地方。
## Robins 原本以为自己已经很小心了
Business Insider 后来访问 Robins。
她说自己过去刻意不做很多父母常见的事情。
例如不拍带有学校名称的开学照。
不在家门口把路牌一起拍进去。
也避免直接公开孩子姓名。
但她后来发现,
有些信息并不是她自己放上去的。
而是其他家人曾经分享过。
她对 Business Insider 说,这次事件让她发现:
即使自己很小心,
家族里其他人的贴文仍可能成为信息的一部分。 :contentReference[oaicite:1]{index=1}
## Meta 自己也承认:这个建议问题不应该出现
Meta 后来对 The Verge 表示:
这项功能这次「missed the mark」。
Meta 发言人 Dina El-Kassaby 表示,
系统根本不应该主动建议这类问题,
而造成个人敏感主题 Prompt 出现的问题已经修正。 :contentReference[oaicite:2]{index=2}
Meta 同时强调:
如果查找者原本看不到某篇内容,
Meta AI 也不应该把那篇内容回传给他。
这个差别非常重要。
目前这起事件不能证明:
任何陌生人都可以用 Meta AI 查出 Robins 家里所有数据。
Business Insider 也特别指出,
现在并不清楚当时只有 Robins 本人看到了那些建议问题,
还是其他陌生人也可能看到完全相同的 Prompt。 :contentReference[oaicite:3]{index=3}
所以真正需要担心的问题,
不是先跳到最夸张的版本:
「AI 已经可以突破所有隐私设置。」
而是另一个更现实的问题:
**我们以前对「公开数据」的理解,可能已经不够用了。**
## 过去,一张照片只是一张照片
你十年前放了一张宝宝照。
五年前放了一次生日照。
去年亲戚又标记了一张旅游照。
单独看,
每一张都没有什么。
问题是,
AI 不一定把它们当成彼此无关的十张照片。
它可以把:
人物。
时间。
关系。
地点。
文字。
照片内容。
全部一起看。
最后得到的不是十篇贴文。
而是一份更完整的「人物背景」。
这就像桌上散着一百片拼图。
以前每个人路过,只看到其中几片。
AI 出现之后,
突然有一个工具可以在几秒钟内开始把拼图拼回去。
## 「我没有公开这件事」和「网络上完全没有这件事」已经是两回事
这也是这个故事对一般人最重要的地方。
很多人的隐私习惯是:
我没有在 Facebook 写地址。
所以地址没有公开。
我没有写孩子姓名。
所以姓名没有公开。
我没有说自己在哪家公司。
所以别人不知道。
但 AI 时代更需要问的是:
**这个答案能不能从我和身边的人以前留下的很多小线索推回来?**
这跟单纯搜索关键字很不一样。
因为 AI 的价值本来就是:
把很多数据集成成答案。
这项能力放在工作里,
可能非常方便。
放到家庭数据上,
感觉就完全不同了。
## 这件事甚至开始改变一些父母拍照与分享的方式
Business Insider 报导,
Robins 的视频爆红之后,
一些家长重新讨论要不要继续公开孩子照片。
甚至有家庭摄影师开始宣布:
未来不再把儿童正脸作品放上社区或网站。
这些人的考量不只来自 Meta AI 这一次事件,
也包括 AI 模型、Deepfake,以及儿童图像被重新利用的风险。 :contentReference[oaicite:4]{index=4}
这并不代表:
父母从今天开始都不能再分享任何家庭照片。
真正需要重新思考的是:
以前我们问:
「这张照片可以公开吗?」
以后可能还要再多问一句:
**「如果 AI 把这张照片跟我过去十年的其他数据放在一起,它还能知道什么?」**
## 这可能才是 AI 时代新的隐私问题
AI 最大的改变,
不只是它知道更多。
而是它整理得更快。
很多数据过去其实已经存在。
只是太分散。
太旧。
太难找。
没有人有耐心全部整理。
AI 把这个成本大幅降低之后,
「公开」这两个字的意思也跟着改变。
以前:
公开一张照片,
可能真的只代表公开一张照片。
现在:
公开一张照片,
可能是又增加了一片未来可以被 AI 拼起来的拼图。
这不代表我们从此什么都不能分享。
但它提醒我们:
隐私可能已经不能只看「这一篇有没有透露太多」。
还要开始看:
**我多年来留下的所有东西,加在一起会变成什么。**
如果是你,
看完这件事之后,
你会减少把孩子或家人的照片放到公开社区吗?
今天,和 AI 一起进步一点。
每天学会一个 AI 技巧。
每天节省一点时间。
每天提升一点能力。
SasaDaily,陪你一起成长。
推荐阅读:
AI 快问快答|2026/08/25:Meta AI 已经读到 Facebook/Instagram 真实数据,就代表它分析出的「原因」一定是真的吗?
https://sasadaily.com/articles/ai-2026-08-25-meta-ai-facebook-instagram
AI 一分钟教学|2026/09/08:HomeAgent 切到 Cloud AI 前,先问「这份原始数据真的需要送出去吗?」
https://sasadaily.com/articles/ai-2026-09-08-homeagent-cloud-ai
履历明明是投给公司看的,为什么现在可能是 AI 先替你打分数,再决定人类要不要看你?
https://sasadaily.com/articles/ai-29