很多公司開始做 AI Agent 後,
第一個成本問題通常會變成:
「是不是該換便宜一點的模型?」
但 Asana 最近公開的一個 Browser Agent 實驗,
提供了另一個答案:
先別急著換模型。
你的工作流本身,
可能就在一直重複花錢。
這是一個真實案例,不是假設公司
Asana 透過旗下:
StackAI
提供企業 AI Workflow Automation。
其中一種工作就是:
Browser Agent。
它可以替使用者:
打開網站、
讀頁面、
填表、
收集資料,
再把結果帶回工作流程。
問題是:
Browser Agent 每往前走一步,
都可能產生更多:
頁面文字、
Screenshot、
Tool Result、
Conversation History。
如果這些東西處理得不好,
Agent 做同一件工作,
成本就會一路往上疊。
Asana 真正先問的不是「哪個模型最便宜?」
StackAI CTO Frank Hidalgo 想解決的是兩件事:
Browser Agent 能不能更便宜?
以及:
能不能更快?
他讓 GPT-6 Astra 在 Codex 裡協助:
閱讀 Codebase、
找出 Agent 怎麼建立每一次 Model Request、
提出改善方案、
跑大量實驗,
最後再比較結果。
Hidalgo 估計,
如果自己人工把整套研究做完,
可能需要:
1~2 個月。
實際這次大約:
一週。
但真正有價值的,
不是 AI 幫工程師省了一週還是一個月。
而是它找到了一個很不起眼的問題:
Context 一直被重新付錢。
第一個浪費點:固定 Prompt 有 Cache,但瀏覽歷史沒有
Browser Agent 每一步都要知道:
自己之前看過什麼。
所以新的 Request 裡,
可能會帶著:
System Prompt。
Tool Definitions。
先前網頁文字。
先前 Screenshots。
操作紀錄。
StackAI 原本已經會 Cache:
固定的 Instructions
和:
Tool Definitions。
但愈來愈長的:
Browsing History
沒有真正有效利用 Cache。
結果就是:
Agent 每走下一步,
又把大量前面已經看過的內容:
重新送一次。
Cache 為什麼重要?
簡單講,
如果模型服務看到:
前面很長一段 Context
和上一個 Request:
完全相同,
某些模型可以直接用:
Cached Input。
Cached Input 通常比重新處理整段內容便宜。
但前提是:
前面那段東西真的沒有被改掉。
這正是 StackAI 第二個問題。
第二個浪費點:Agent 幾乎每一步都在改舊 History
StackAI 原本會:
丟掉舊 Screenshot。
裁掉較早的 Page Text。
目的是避免:
Context 無限變長。
直覺上這很合理。
問題是:
每次你改掉前面的 History,
整個 Request Prefix 就變了。
Cache 原本可以重用的部分,
也跟著被破壞。
所以:
有 Cache 功能
不代表:
Cache 真的有被大量使用。
這也是 Asana 實驗裡很值得一般企業記住的一點。
第三個浪費點:Screenshot 刪得太勤
Browser Agent 很常靠 Screenshot 理解畫面。
但圖片 Context 也會增加成本。
所以原本做法是:
很快就把舊 Screenshot 移除。
Asana 後來測試另一種方法:
不要每一步都改 History。
而是先累積 Screenshot。
到一定數量,
再:
一次大量 Prune。
最佳測試方案之一是:
最多先保留:
20 張 Screenshot。
到門檻後,
再一次縮回:
最近一張。
這樣中間約 19 次呼叫,
History 前段都可以保持穩定,
Cache 才比較容易真正命中。
第四個改變:反而讓 Agent 記得更多
這點很反直覺。
很多人想降 Token,
第一個想法是:
「把 Context 刪短一點。」
但 StackAI 測試的結果反而顯示:
History 太小,
Agent 可能忘掉前面已經找到的東西。
然後:
重新找。
重新開頁。
重新讀。
甚至最後做不完。
團隊比較了:
120,000 Characters
和:
480,000 Characters
兩種 History Budget。
在部分較新的模型上,
120,000 Characters 根本不夠。
GPT-6.1 Sol 在這個較小 Budget 下,
18 次測試只有:
3 次完成。
提高到:
480,000 Characters
後,
相關測試全部可以完成。
所以:
Context 少
不一定等於:
總成本低。
如果 AI 因為忘記前文而:
重複工作,
最後反而可能更貴。
他們怎麼測,而不是只憑感覺?
Asana/StackAI 這次沒有:
改完一次,
看到結果好像比較快,
就直接宣布成功。
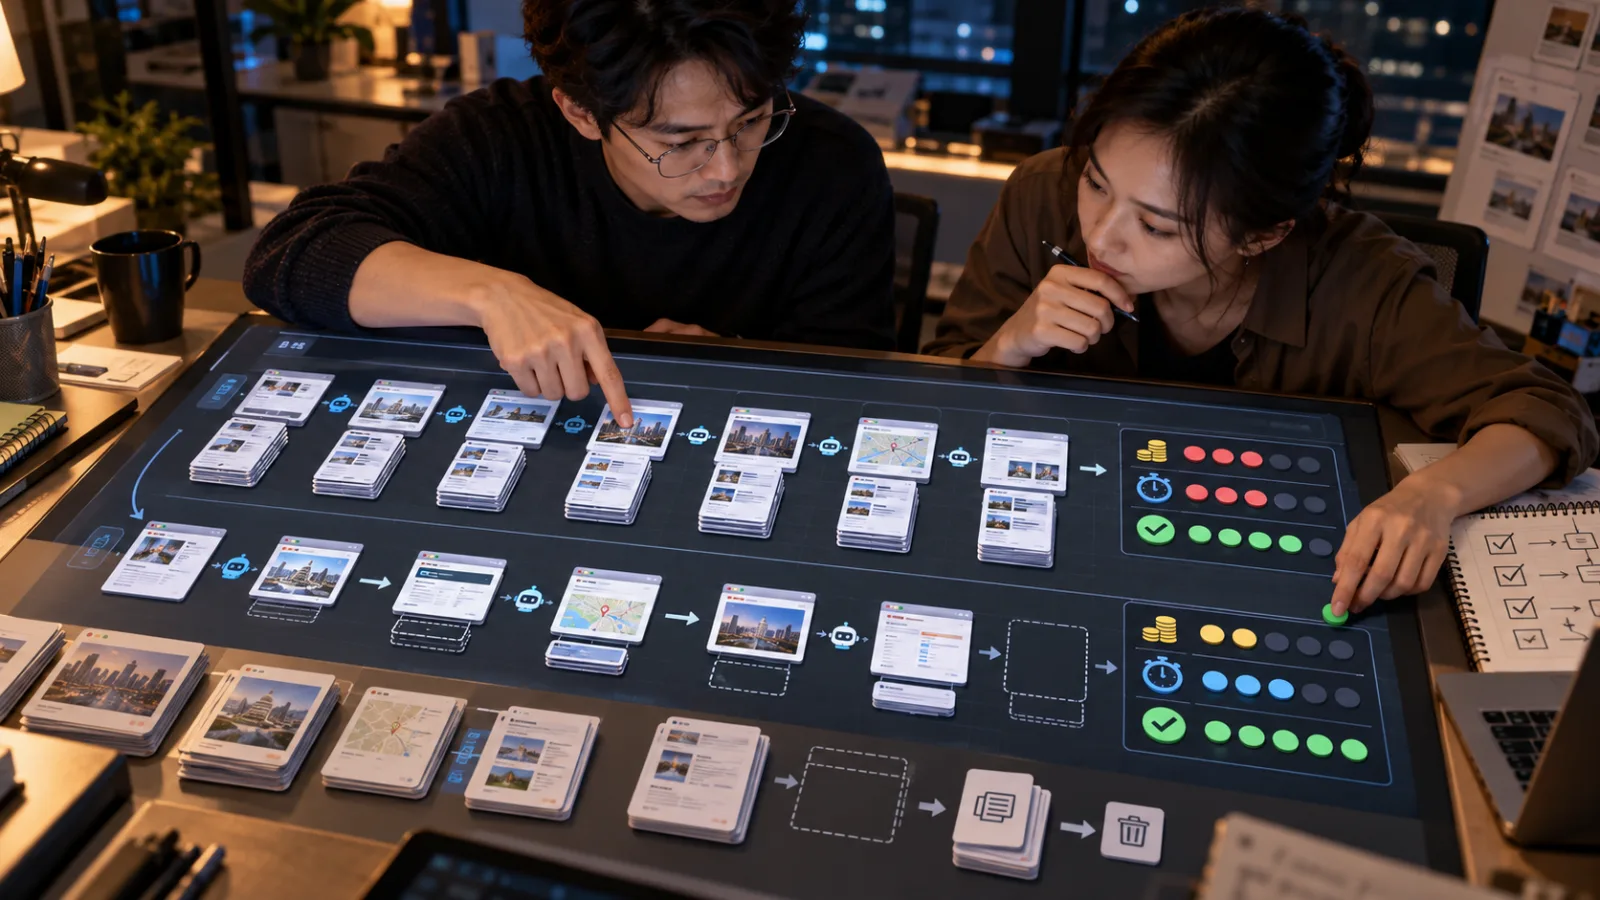
正式研究跑了:
144 次。
測試:
4 個不同模型。
2 種 History Budget。
6 種 Caching/Screenshot Policy。
每一個條件再跑:
3 次。
之後還另外做:
12 次 Follow-up。
每個 Agent 做的也是:
同一個固定任務。
固定任務到底是什麼?
Agent 要從一個公開 Demo Book Catalog,
替:
32 本書
各自收集:
6 個欄位。
也就是總共需要找到:
192 個 Facts。
這點非常重要。
因為如果:
A 模型做簡單任務,
B 模型做難任務,
最後比較:
Cost
根本沒有意義。
Asana 把:
Task
固定。
再比較:
Cost。
Runtime。
Result Quality。
這才有辦法知道:
到底是哪一個改動真的有效。
最後結果是多少?
在最佳 GPT-6.1 Sol Workflow 上,
平均每次 Run 的:
Estimated Model Cost 約 0.47 美元。
時間約:
4 分鐘。
相較原本使用 Model B 的 Production Setup,
OpenAI/Asana 公布的比較是:
成本:
低 76 倍。
速度:
快 5 倍。
而最佳條件下,
Agent 仍然找到:
全部 192 個 Facts。
但「76 倍」一定要拆開看
這是整篇最重要的 Boundary。
不要看到:
76x
就理解成:
「把 Cache 打開,所有 AI Agent 都會便宜 76 倍。」
不是。
這個 76 倍比較的是:
原本 Production Workflow+Model B
對上:
優化後 Workflow+GPT-6.1 Sol。
它同時包含:
工作流優化
和:
模型差異。
如果只看同一個:
Model B,
Asana 的工作流優化把:
每次估算 Model Cost
從至少:
36.21 美元
降到:
1.24 美元。
大約是:
29 倍。
這已經非常大。
但它也證明:
headline 裡的 76 倍,
不能全部歸功於 Cache,
也不能全部歸功於 GPT-6.1 Sol。
而且 36.21 美元的 Baseline 還有一個限制
部分原始 Run:
甚至在完成任務前,
就已經碰到:
Step Limit。
所以原本的:
36.21 美元
是:
至少。
這也代表研究比較不是:
「兩套完全相同、每次都完美完成的正式產品帳單」。
它是一組特定:
Browser Benchmark
下的實驗結果。
所以不能拿:
0.47 美元
直接套到:
你公司的客服 Agent、
採購 Agent、
研究 Agent
身上。
這篇真正值得小公司學的是什麼?
不是:
立刻換成 GPT-6.1 Sol。
也不是:
照抄 480,000 Characters。
真正值得學的是:
當 AI Workflow 太貴時,
不要第一個就問:
「哪個模型單價最低?」
先拆四件事。
1. 同樣的 Context 有沒有一直重送?
例如:
公司規則。
產品手冊。
前面已經讀過的頁面。
Tool Definitions。
Conversation History。
如果每一輪都重新付完整 Input Price,
那就要看:
Cache
有沒有真正命中。
2. Agent 有沒有因為忘記而重做?
把 Context 壓得太小,
有可能:
少送 Token。
但如果 Agent 因此:
重開網站、
重查資料、
重讀文件,
整體 Cost
反而更高。
所以不要只看:
每一次 Request 多長。
要看:
完成整件工作總共花多少。
3. 圖片與 Screenshot 是不是每一步都在改?
Computer Use/Browser Agent
最容易出現這種情況。
畫面一直變。
Screenshot 一直加。
又一直刪。
如果每一步都改 History,
Cache 很難保持穩定。
真正值得測的是:
哪些畫面一定要留?
多久整理一次?
能不能 Batch Pruning?
而不是:
看到圖片很貴,
就全部刪掉。
4. 最後有沒有完成同一件事?
這是最重要的。
假設原本 Agent:
100 次有 95 次完成。
改完後成本少一半,
但:
100 次只剩 60 次完成。
那不能直接說:
成本下降 50%。
因為失敗的 40 次:
還是得重跑、
人工接手
或重新處理。
真正要看的是:
Cost per Correct Completed Task。
不是:
單次 Token Cost。
小團隊可以怎麼抄這個方法?
不用做 144 次實驗。
先從:
20 個固定案例
開始就可以。
挑一個你真的每天會跑的工作。
例如:
查 10 個競品網站。
整理 20 張發票。
更新 15 筆 CRM。
處理 20 個客服問題。
然後固定:
輸入。
完成條件。
答案格式。
再一次只改:
一個變數。
第一輪只記四個數字
成功率
20 次裡,
真正完成幾次?
平均成本
完成一次平均花多少?
平均時間
一個 Task 多久?
人工修正時間
AI 做完後,
人還要花多久收尾?
這四個數字比:
「Model X Benchmark 比 Model Y 高」
更接近:
企業真正的 ROI。
然後才去找 Bottleneck
如果成本高,
先問:
是不是 Context 重送?
如果時間長,
先問:
是不是 Agent 一直重複找?
如果成功率低,
先問:
是不是 History 太小、
工具不穩
或任務本身沒有定義清楚?
如果人工修改很多,
先問:
是不是 AI 根本做錯了最重要的那一步?
不同問題,
答案不一定都是:
換模型。
Asana 還做對一件很重要的事:完整保存每次 Experiment
這次 GPT-6 Astra 跑過的:
Requests、
Data Traces、
Results
都有留在:
Asana Command。
後面才能:
回頭比對。
找異常。
產生 Ticket。
做 Pull Request。
讓人 Review。
最後才進 Production。
這點對小公司同樣重要。
不要只記:
「這次好像變快了。」
至少要留下:
版本。
Prompt。
模型。
設定。
Cost。
時間。
結果。
否則兩週後:
你根本不知道是哪一個修改真正有效。
AI 幫忙優化 AI,也不代表人可以退出
Asana 這次真正的分工很清楚。
人做什麼?
定義 Goal。
決定哪些方案值得測。
定義正確答案。
審查結論。
Review Production Change。
AI 做什麼?
讀 Code。
找可能的 Bottleneck。
建立測試。
大量跑 Experiment。
分析 Trace。
整理結果。
這是一個很典型的:
Human+Agent
工作模式。
不是:
「GPT-6 Astra 自己決定怎麼改 Production。」
這個案例最值得企業記住的一句話
當 AI Agent 開始真的大量跑,
最大的問題可能不再是:
它會不會做。
而是:
每成功做完一次,到底要多少錢?
所以 AI Workflow 從 Demo 進 Production 前,
至少要開始量:
成功率。
成本。
時間。
人工修改。
而不是只問:
「Agent 跑成功了嗎?」
因為一個:
每次都能完成、
但一件工作花 30 美元
的 Agent,
和:
同樣正確、
每次只花 0.50 美元
的 Agent,
商業上完全是兩個不同產品。
Asana 這次最值得看的,
不是它得到:
76x。
而是它把:
「AI 太貴」
從一句抱怨,
拆成:
可以測、
可以比較、
可以找到原因
的工程問題。
如果你也想知道自己的工作裡,哪一步最適合先交給 AI,留言「流程」。
推薦閱讀
AI 商業案例|2026/10/06:5 人市場情報團隊怎麼讓 AI Agent 每天追 20 個網站?先設「來源/請求上限/超量就停」
AI 一分鐘教學|2026/09/23:Claude Code 跑完別只看答案,輸入 /usage 用「Cache/Output/Turns」找出哪裡在燒錢