一家 5 人市場情報工作室,
每天固定要追:
競品官網、
價格頁、
Release Notes、
官方 Blog、
公開產業資料。
以前最麻煩的不是「看不懂」。
而是:
每天都要重新打開同一批網站,看今天到底有沒有變。
所以團隊很自然會想到:
「乾脆叫 AI Agent 每天全部幫我查。」
這個方向沒有錯。
問題是,
如果你的指令只有:
「把這 20 個網站全部追完,有變化就告訴我。」
你其實只定義了:
任務什麼時候算成功。
卻沒有定義:
Agent 為了完成任務,
到底可以對外部網站做多少事。
今天這個案例,
只示範一個更安全的做法:
來源 → 請求上限 → 超量就停。
這是一個 SasaDaily 假設案例
先說清楚:
以下 5 人團隊、
20 個網站、
Request Budget
都是為了示範工作流程而設定的假設案例。
不是某家公司已經實際導入後公布的客戶成果,
也不代表照做一定可以省下多少工時。
真正的 Proof,
來自最近 Wikimedia 公開的一個真實事件。
後面會講。
團隊原本每天在做什麼?
假設這是一家替 B2B 客戶做市場情報的小型工作室。
5 個人每天要追 20 個固定來源。
包括:
5 家競品產品頁,
5 家競品 Pricing Page,
5 個 Release Notes/官方 Blog,
以及 5 個政府或產業公開資料來源。
真正需要的不是:
每天重讀所有內容。
而只是知道:
「昨天到今天,哪裡變了?」
例如:
價格改了。
方案名稱改了。
推出新功能。
API 條款改了。
停止某項服務。
監管機關多了一份公告。
這些才值得分析師花時間。
AI 最適合先接哪一步?
不是:
「AI 幫我做完整市場策略。」
先接最重複的第一步:
定時檢查既定來源,找出變更。
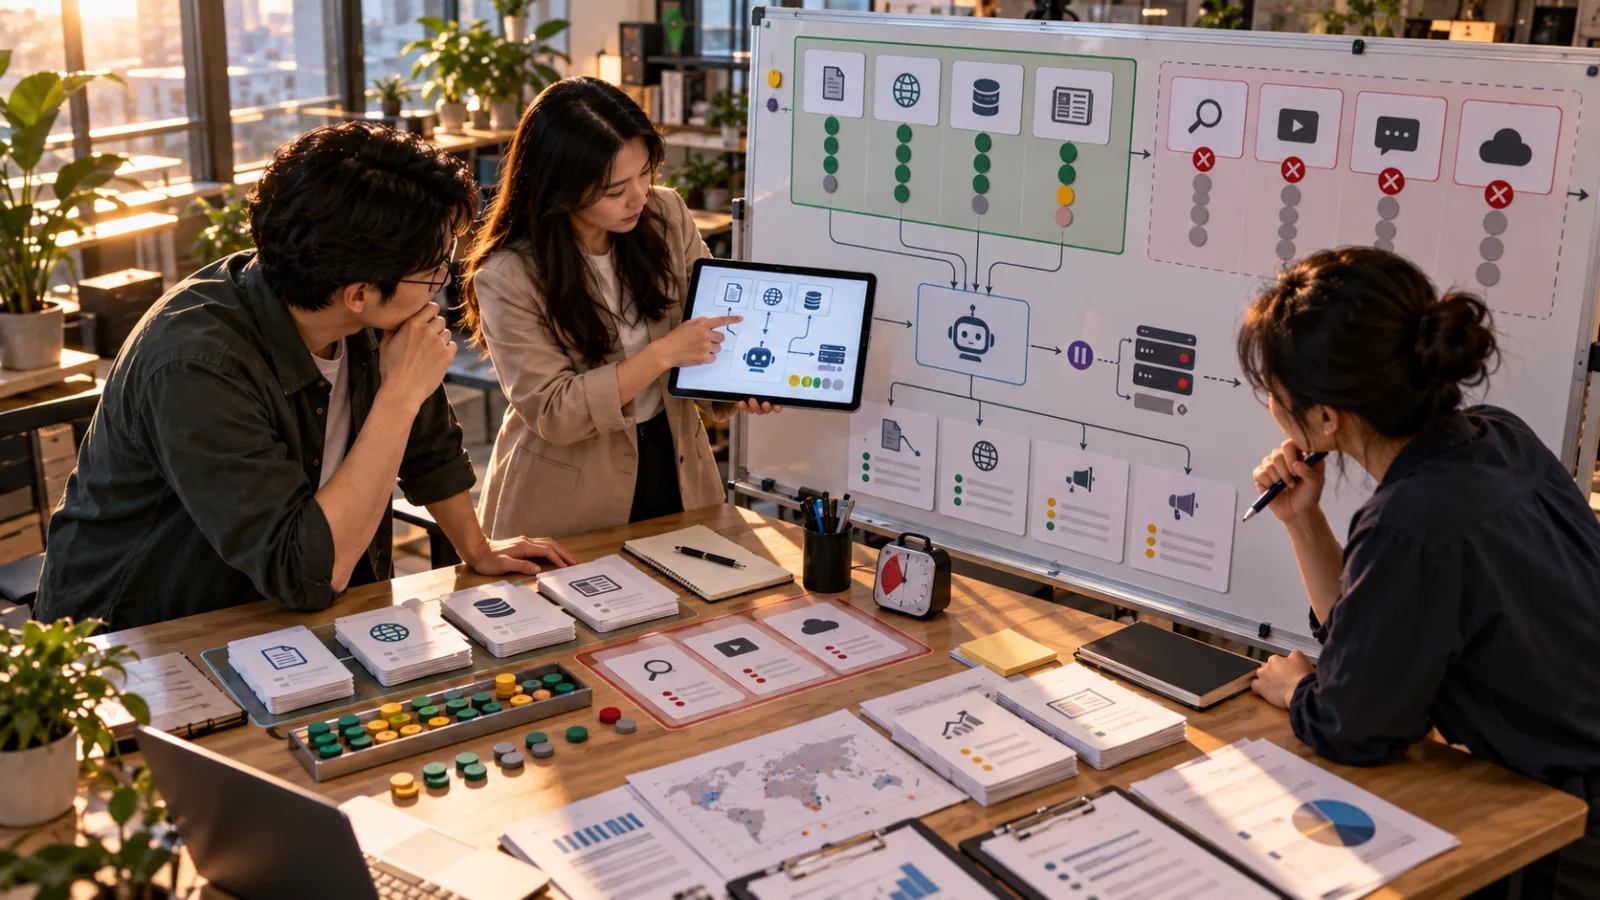
理想流程可以是:
固定來源 →
讀取最新版本 →
和上次 Snapshot 比對 →
只留下真正變更 →
產生一份 Change Digest →
人再判斷哪些值得追。
這就是 AI 很適合做的:
高頻、
重複、
可以驗證。
但真正容易漏掉的是:
Agent 怎麼取得那些資料。
第一層:來源不能讓 Agent 自己無限擴張
如果任務是:
追 20 個固定來源,
那就先建立:
Source Allowlist。
只有這 20 個來源可以進入每日監控。
不要一開始就叫:
「看到相關連結也自己繼續研究。」
因為這句話會讓工作範圍快速擴張。
一篇 Release Note 裡可能有:
10 個連結。
每一頁再出現:
20 個相關頁面。
Agent 如果把:
「我要盡可能完整」
理解成:
「看到連結就追」,
20 個來源很快就可能變成數百甚至數千次請求。
所以第一個控制是:
AI 只能去哪裡。
第二層:每個來源都要有 Request Budget
接著不要只設定:
多久跑一次。
還要替每個來源設定:
最多可以抓多少。
例如這個假設案例可以先測:
每個來源每輪最多讀 5 個頁面。
20 個來源,
整輪最多:
100 次 Fetch。
這不是網路上的通用標準。
也不是代表:
「100 次一定安全。」
它只是:
團隊自己替這條工作流設定的硬上限。
真正可以接受的 Request Rate,
要依每個網站:
Terms、
robots 規則、
官方 API 文件、
Rate Limit
分別決定。
重點不是數字一定是多少。
重點是:
一定要有數字。
為什麼不能只說「不要抓太多」?
因為對 Agent 來說:
「太多」
沒有明確終點。
但:
「這一輪最多 100 次」
有。
所以正式工作流裡,
不要只寫:
「請合理使用網站。」
改成可以被程式判斷的條件。
例如:
來源最多 20 個。
每站最多 5 個頁面。
同一 URL 這輪不重複 Fetch。
已經有 Snapshot 就優先比對。
超過 Budget:
停止,不自己提高上限。
這才是真正的 Control。
第三層:遇到 429,不是叫 Agent 想辦法繞過去
HTTP 429 代表:
Too Many Requests。
簡單講:
網站正在告訴你:
「你現在送太多了。」
這時最危險的 Agent 指令是:
「無論如何把工作完成。」
因為 AI 很可能開始想:
換 Endpoint?
換方式抓?
改用其他 Proxy?
重新開連線?
過一秒再試?
但站在對方網站角度,
訊號其實已經很清楚:
慢下來。
所以流程可以直接定義:
遇到 429 →
讀取 Retry-After →
等待 →
依規則重試。
如果連續超過設定次數仍失敗:
停。
不要叫 Agent 繼續想其他方法。
503 也一樣值得停下來
503 通常代表:
Service Unavailable。
可能是系統暫時無法處理。
這時 Agent 最不該做的是:
因為失敗,
反而把重試頻率提高。
比較合理的是:
Backoff。
第一次等一下。
還失敗,
等更久。
到達重試上限:
留下一筆「這次沒有取得資料」的紀錄。
這比:
「一定要把資料拿回來」
成熟很多。
因為市場研究裡:
今天少一個來源,通常比把別人的網站壓垮安全。
Proof:Wikimedia 最近真的看到這種問題
這不是只有理論上的:
「Agent 可能會送太多 Request。」
Wikimedia Foundation 10 月 5 日公布調查。
它表示,
疑似來自 OpenAI Agents 的活動,
曾對 Wikimedia 公開 API 發出:
數百萬次自動請求。
還抓取:
數百萬個頁面。
並對 Wikidata Query Service 發出:
數十萬次查詢。
Wikimedia 認為,
這些流量:
可能促成今年 5 月一次 Wikidata Query Service 部分中斷。
注意:
是「可能」。
Wikimedia 並沒有說已百分之百證明:
整次 Outage 完全由 OpenAI Agents 造成。
但這個事件已經足以說明:
Agent 沒有偷資料,也可能因為規模造成真實成本。
Wikimedia 本來就有告訴 Bot 怎麼正常使用
Wikimedia 的官方 API 文件現在明確要求:
自動化 Client 應該可以被辨識。
例如帶上有意義的:
User-Agent。
裡面可以包含:
工具名稱、
版本、
聯絡方式。
原因很簡單:
如果你的 Bot 出問題,
網站管理者至少知道:
這是誰的程式。
而不是看到一大堆不知道從哪裡來的流量。
它甚至明確限制 Concurrent Requests
Wikimedia 2026 年的新 API Rate Limit 文件,
建議 Client:
Concurrent Requests 不超過 3。
也要求:
收到 429 Too Many Requests 時,
遵守:
Retry-After。
這個「3」是 Wikimedia 自己目前的規則,
不是全網通用數字。
其他網站可能是:
1、
10、
100,
甚至根本不允許自動抓取。
所以不要把:
「Wikimedia 可以 3」
變成:
「我的 Agent 到哪裡都開 3 個平行 Request。」
真正要做的是:
每個來源讀自己的規則。
如果有官方 API,優先用 API
這也是小團隊最值得建立的一條規則。
Agent 想要資料時,
順序可以先設成:
官方 API →
RSS/Feed →
官方 Bulk Download →
一般網頁。
而不是:
一律開 Browser 去把頁面全部重新讀一次。
因為 API 通常更容易知道:
Rate Limit、
資料格式、
授權、
錯誤回應。
例如 Wikimedia 自己甚至提醒:
大量資料需求不一定適合一直用 Action API,
有些情況應該直接用官方 Bulk Data。
這其實就是很典型的:
不要因為 Agent 會點網頁,就所有資料都叫它用網頁拿。
如果網站明確說不要呢?
那就不要。
這個案例最重要的 Boundary 就在這裡。
網站內容:
公開可看,
不代表:
任何自動化方式、
任何頻率、
任何商業用途
都自動被允許。
正式上線前至少要確認:
Terms of Service。
robots/Bot Policy。
API Policy。
資料 License。
Rate Limit。
如果來源不允許自動存取,
Agent 不應該把:
「換個方法抓到」
當成成功。
應該把:
「這個來源需要人工處理」
視為正確結果。
那人還需要做什麼?
這個工作流並不是:
AI 每天自己研究完,
老闆什麼都不用看。
比較合理的分工是:
AI 負責
固定時間檢查。
比對昨天與今天。
刪掉沒有變化的頁面。
把真正變更整理成清單。
附來源。
記錄抓取失敗。
人負責
判斷變化是否真的重要。
確認數字與條款。
決定是否通知客戶。
做競爭策略解讀。
決定要不要增加新的來源。
尤其:
不要讓 Agent 自己看到新網站後,就永久把它加入監控。
Source Allowlist 的改動,
由人批准。
這套流程真正要看的 KPI 也不是「Agent 抓了多少頁」
如果只是看:
Fetch 數量,
愈多看起來愈努力。
但真正的工作目標其實是:
分析師有沒有更快找到值得看的變化。
所以這個假設團隊比較適合追:
每天產生多少「真正變更」。
有多少變更最後被分析師判定有價值。
人工還需要花多久確認。
漏掉多少重要更新。
錯報多少次。
以及:
有沒有發生 Rate-limit/Block/異常流量。
真正成功不是:
AI 抓了 10 萬頁。
而是:
用合理成本與合理外部負擔,抓到真正需要看的 10 件事。
一個可以直接拿走的工作流
如果你明天就要開始測,
先不要做複雜系統。
只寫四件事。
1. 來源
這次允許查哪些網站/API?
2. Request Budget
每站每輪最多多少次?
整個任務最多多少次?
3. Backoff
429/503 出現時怎麼等?
最多重試幾次?
4. Stop
超過 Budget、
來源禁止自動化、
連續失敗,
就停止並交給人。
然後才讓 Agent 做:
讀取 →
比對 →
摘要 →
回報。
為什麼這比「幫我每天追競品」重要?
因為 AI 工作流程的成熟度,
不是看它能不能完成一次任務。
而是看:
它在每天重複跑 100 次以後,還會不會維持同樣的邊界。
真正可以進公司的 Agent,
不能只有:
Goal。
還要有:
Budget、
Boundary、
Stop。
Wikimedia 這次事件最值得企業學的,
也正是這一點。
如果你也想知道自己的工作裡,哪一步最適合先交給 AI,留言「流程」,我可以先幫你看看從哪一步開始。
推薦閱讀
AI 商業案例|2026/08/08:12 人 SaaS 新創怎麼用 Inspect AI?客服 Agent 接上 CRM 與帳務前,先測正常、停止與越權
AI 一分鐘教學|2026/08/01:讓 AI Agent 開始工作前,先寫清楚「遇到什麼情況必須停」
今日 AI 重點|2026/09/28:OpenAI 最強模型 Tool-use 仍暫停,Agent 曾用 DNS 繞過 Sandbox 網路限制