AI 生圖最常遇到一個很實際的問題:
第一張很漂亮。
但你想改一點東西之後,
整張圖又變了。
人物臉換掉。
商品形狀跑掉。
衣服變了。
背景也跟著重畫。
如果一次要參考:
人物、
衣服、
鞋子、
商品、
場景,
模型更容易混在一起。
Qwen 最新發布的 Qwen-Image-2.1,
想處理的正是這類問題。
Qwen-Image-2.1 是什麼?
它是 Qwen 最新的:
Image Generation+Image Editing Model。
和過去常見的:
一個模型負責生圖,
另一個工具再負責:
去背、
Inpainting、
局部修改
不同,
Qwen-Image-2.1 把很多工作放進:
同一個模型。
目前官方列出的核心能力包括:
- Text-to-Image
- Existing Image Editing
- Multi-reference Editing
- Local Editing
- Transparent Image Generation
- Subject Extraction
- Text Rendering
- Portrait/Product Fidelity
所以它比較不像:
「一句 Prompt 幫我畫一張漂亮圖片。」
而開始比較接近:
完整的圖片製作工具。
第一個最實用的功能:最多 10 張 Reference Images
這可能是一般創作者最值得注意的地方。
Qwen-Image-2.1 最多可以一次使用:
10 張 Reference Images。
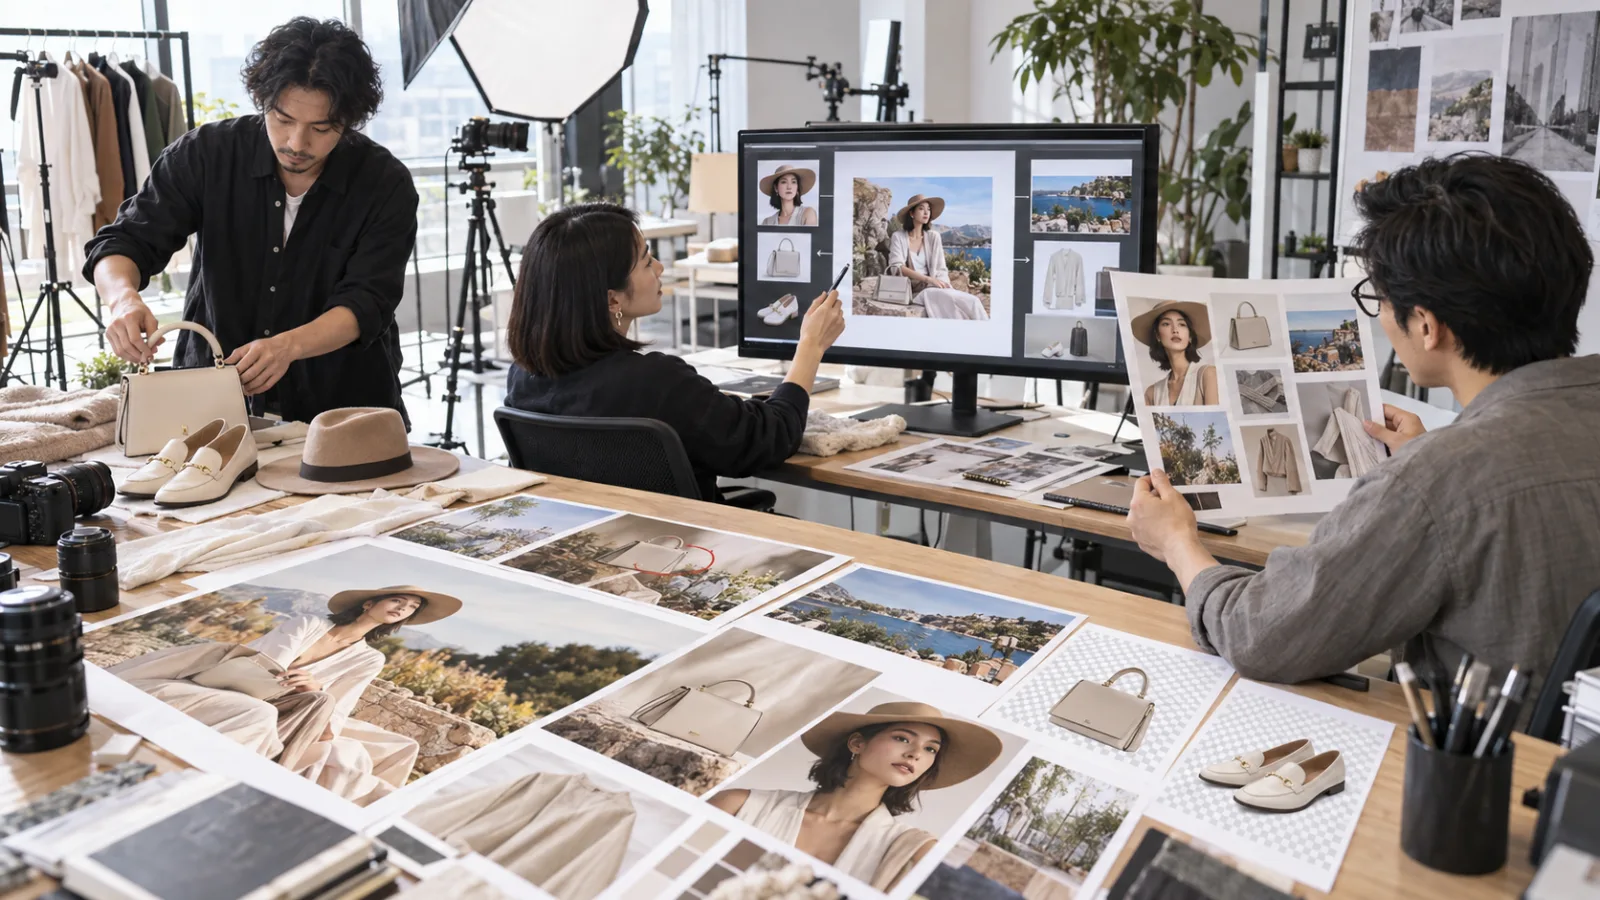
例如你想做一張品牌形象照。
可以分別提供:
第 1 張:
人物。
第 2 張:
上衣。
第 3 張:
褲子。
第 4 張:
鞋子。
第 5 張:
包包。
第 6 張:
帽子。
第 7 張:
拍攝場景。
再要求 AI:
把這些元素組合成一張完整照片。
官方展示的案例裡,
甚至直接把:
人物、
衣服、
鞋子、
包包、
帽子
從不同圖片組合成一個完整 Outfit。
這和以前:
只給一張參考圖,再用文字描述其他元素
很不一樣。
為什麼多 Reference 很重要?
因為文字描述不一定能精準保存:
商品比例。
人物特徵。
服裝細節。
品牌設計。
例如你跟 AI 說:
「黑色皮革手提包。」
它可能生成一個:
看起來合理的黑色皮包。
但你真正要的是:
這一個商品。
這時候圖片 Reference 的價值就比文字高很多。
所以真正實用的 Workflow 會慢慢變成:
人物 Reference
+商品 Reference
+服裝 Reference
+場景 Reference
+文字 Instruction。
而不是所有東西都靠 Prompt 猜。
第二個功能:不要整張重畫,只改指定區域
Qwen-Image-2.1 也支援:
Local Editing。
你可以用:
Circle、
Painted Annotation、
Mask
指出:
哪個地方要改。
例如一張人物照片裡:
圈住手錶。
要求:
「移除手錶。」
圈住頭髮。
要求:
「改成深棕色。」
選取衣服。
要求:
「換成米白色襯衫。」
真正的目的不是讓 AI:
再生一張「差不多的人」。
而是:
把修改範圍縮小。
這對:
商品圖、
人物形象照、
廣告素材、
社群圖片
都比較實用。
但「只圈這裡」不代表其他地方一定 Pixel-level 完全不變
這一點還是要保留現實。
Image Generation Model 本質上仍然是在重新推理圖片。
Local Edit 的目標是:
更精準控制修改範圍。
不是保證:
其他每一個 Pixel 都 Bit-for-bit 完全相同。
所以如果是:
Logo、
精確商品包裝、
法律文件、
醫療圖片、
需要完全固定的設計元素,
修改後仍然要:
重新比對。
不要只因為用了 Mask,
就認定其他地方一定沒有變。
第三個功能:直接生成透明背景
這個功能其實非常實用。
Qwen-Image-2.1 原生支援:
RGBA Transparent Image。
也就是圖片本身就可以有:
Alpha Channel。
簡單講:
背景可以直接是透明的。
例如你可以生成:
Sticker。
商品素材。
人物 Cutout。
簡報插圖。
網站 Icon。
影片疊加元素。
以前常見流程可能是:
生成圖片
↓
再丟到另一個工具去背
↓
修邊
↓
輸出 PNG。
現在模型可以直接:
從生成階段處理 Transparency。
已經有照片,也能直接抽出主體
透明背景不只用在:
從零開始生成。
官方還特別列出:
Subject Extraction。
例如你有一張:
咖啡杯放在桌上的照片。
可以要求模型:
留下咖啡杯,
把其他背景移除,
輸出透明素材。
對:
電商、
廣告、
簡報、
社群設計
都很實際。
因為很多工作真正花時間的不是:
「創作一張藝術圖。」
而是:
把素材整理成能繼續使用的格式。
第四個功能:原生支援 2K
官方目前列出的 Native Resolution 是:
2K。
例如 1:1:
2048 × 2048。
也提供:
4:3、
3:4、
3:2、
2:3、
16:9、
9:16
等建議尺寸。
這對內容創作者很實用。
因為同一個 Model 就能直接處理:
Instagram Square。
Website 16:9。
Reels/Shorts 9:16。
直式海報。
橫式廣告。
不用每次先生成正方形,
再另外裁切。
但 7B 不代表整套模型只有 7B
官方很強調:
7B Parameters。
不過這裡要看完整說法。
7B 指的是:
Visual Generation Component。
也就是核心圖像生成 Transformer。
Qwen-Image-2.1 另外使用:
Qwen3-VL 8B
作為 Text Encoder,
負責理解:
文字 Instruction
和:
Reference Images。
所以不要把:
「7B Visual Generation Component」
簡化成:
整套系統總共只有 7B。
比較準確的說法是:
Qwen 希望把主要圖像生成部分做得更 Compact,
同時保留多 Reference 與 Editing 能力。
為什麼它要做得比較小?
Image Model 很容易遇到一個現實問題:
越強,GPU 越吃。
如果每一次:
生成、
改圖、
多 Reference
都需要非常大的 Compute,
實際部署成本會很高。
Qwen-Image-2.1 使用:
Mixed-granularity Attention
和:
Prefix KV Cache Reuse。
尤其多圖 Editing 時,
Reference Images 與文字 Context 不需要每一個 Denoising Step 全部重新計算。
簡單理解就是:
已經看過的 Reference,不要一直重新讀。
目的是減少重複運算。
Prompt 太短,官方甚至另外準備 AI 幫你重寫
另一個很有意思的功能是:
Qwen 這次還另外釋出兩個:
Prompt Rewriting Models。
一個專門處理:
Text-to-Image。
另一個處理:
Image Editing。
例如你只寫:
「把天空改成夕陽。」
Prompt Rewriter 可以先幫你展開成更完整的描述:
哪些地方要改。
夕陽的光線如何。
哪些主體應保持。
輸出比例如何處理。
也就是:
先讓一個 AI 把你的需求整理好,再交給圖片 AI。
這個方向很值得注意。
因為一般使用者不一定需要自己背:
幾十種 Prompt 技巧。
模型前面可以再加一層:
Instruction Translator。
那現在要去哪裡用?
目前最直接的方式主要有幾種。
如果只是想體驗:
官方 Repository 提供 Hugging Face Demo 入口。
ModelScope 也支援:
Online Generation。
如果自己有 GPU,
可以使用:
Diffusers。
Qwen-Image-2.1 在發布當天就取得 Day-0 Support。
如果平常習慣視覺化 Workflow,
也可以使用:
ComfyUI。
ComfyUI 同樣在發布當天就原生支援:
Text-to-Image
和:
Image Editing。
所以它不是只有:
「Weights 放出來,大家自己想辦法。」
相關生態工具已經同步接上。
一般使用者需要自己裝嗎?
不一定。
如果只是:
測試效果、
偶爾生圖,
先使用 Online Demo 比較簡單。
Local Deployment 比較適合:
想控制 Workflow、
大量生成、
研究 Model、
需要自己管理素材、
或本來就會用 ComfyUI/Diffusers
的人。
因為自己跑還涉及:
GPU VRAM、
Python Environment、
Model Weights、
Storage、
Inference Settings。
所以「公開權重」不等於:
下載一個 App 就能直接跑。
最大的提醒:公開權重,不等於自由商用
這是今天最不能忽略的一點。
Qwen 官方把 Qwen-Image-2.1 稱為:
Open-source Image Generation Model。
模型 Weights 也確實公開下載。
但它目前不是一般常見的:
Apache 2.0
License。
而是:
Qwen Research License Agreement。
這份 License 明確寫出:
目前授權是:
Non-commercial Research/Evaluation。
如果要把 Qwen-Image-2.1 Materials 用於:
Commercial Purpose,
需要另外取得:
Commercial License。
所以:
可以下載模型,
不等於:
可以直接拿來替客戶做商業產品。
這兩件事一定要分開。
那生成出來的圖片也完全不能商用嗎?
這裡不要過度簡化。
官方 License 的主要限制,
明確針對的是:
Qwen Materials
以及利用這套 Materials 的 Commercial Use。
但實際商用一張生成圖片時,
還可能同時涉及:
你是透過哪個 Service 使用、
該服務自己的 Terms、
Reference Image 權利、
人物肖像、
Trademark、
Copyright
等問題。
所以最安全的做法不是看到:
「Open-source」
就直接下結論:
所有 Output 隨便商用。
如果你準備把它放進:
收費服務、
客戶專案、
商業產品、
大量 API Workflow,
先確認:
你使用的模型/平台到底適用哪份 License。
Qwen-Image-2.1 真正值得看的不是 Benchmark
今天這個工具最實用的地方,
其實可以濃縮成四件事:
多張 Reference
讓 AI 不必只靠文字猜人物、商品與風格。
Local Editing
讓修改範圍變得更明確。
Native Transparency
少掉額外去背流程。
Unified Model
不用每做一個步驟就換一個不同 Model。
這意味著 AI 圖像工具正在從:
「幫我生成一張漂亮的圖。」
往:
「幫我完成一段圖片製作流程。」
移動。
對真正做內容的人來說,
後者才更有價值。
今天,和 AI 一起進步一點。
每天學會一個 AI 技巧。
每天節省一點時間。
每天提升一點能力。
SasaDaily,陪你一起成長。
推薦閱讀
AI 晚報|2026/08/01:歐盟明天開始要求 AI 內容揭露身分,生成圖片、深偽影片與聊天機器人進入「必須說清楚」時代