AI 生图最常遇到一个很实际的问题:
第一张很漂亮。
但你想改一点东西之后,
整张图又变了。
人物脸换掉。
商品形状跑掉。
衣服变了。
背景也跟着重画。
如果一次要参考:
人物、
衣服、
鞋子、
商品、
场景,
模型更容易混在一起。
Qwen 最新发布的 Qwen-Image-2.1,
想处理的正是这类问题。
Qwen-Image-2.1 是什么?
它是 Qwen 最新的:
Image Generation+Image Editing Model。
和过去常见的:
一个模型负责生图,
另一个工具再负责:
去背、
Inpainting、
局部修改
不同,
Qwen-Image-2.1 把很多任务作放进:
同一个模型。
目前官方列出的核心能力包括:
- Text-to-Image
- Existing Image Editing
- Multi-reference Editing
- Local Editing
- Transparent Image Generation
- Subject Extraction
- Text Rendering
- Portrait/Product Fidelity
所以它比较不像:
「一句 Prompt 帮我画一张漂亮图片。」
而开始比较接近:
完整的图片制作工具。
第一个最实用的功能:最多 10 张 Reference Images
这可能是一般创作者最值得注意的地方。
Qwen-Image-2.1 最多可以一次使用:
10 张 Reference Images。
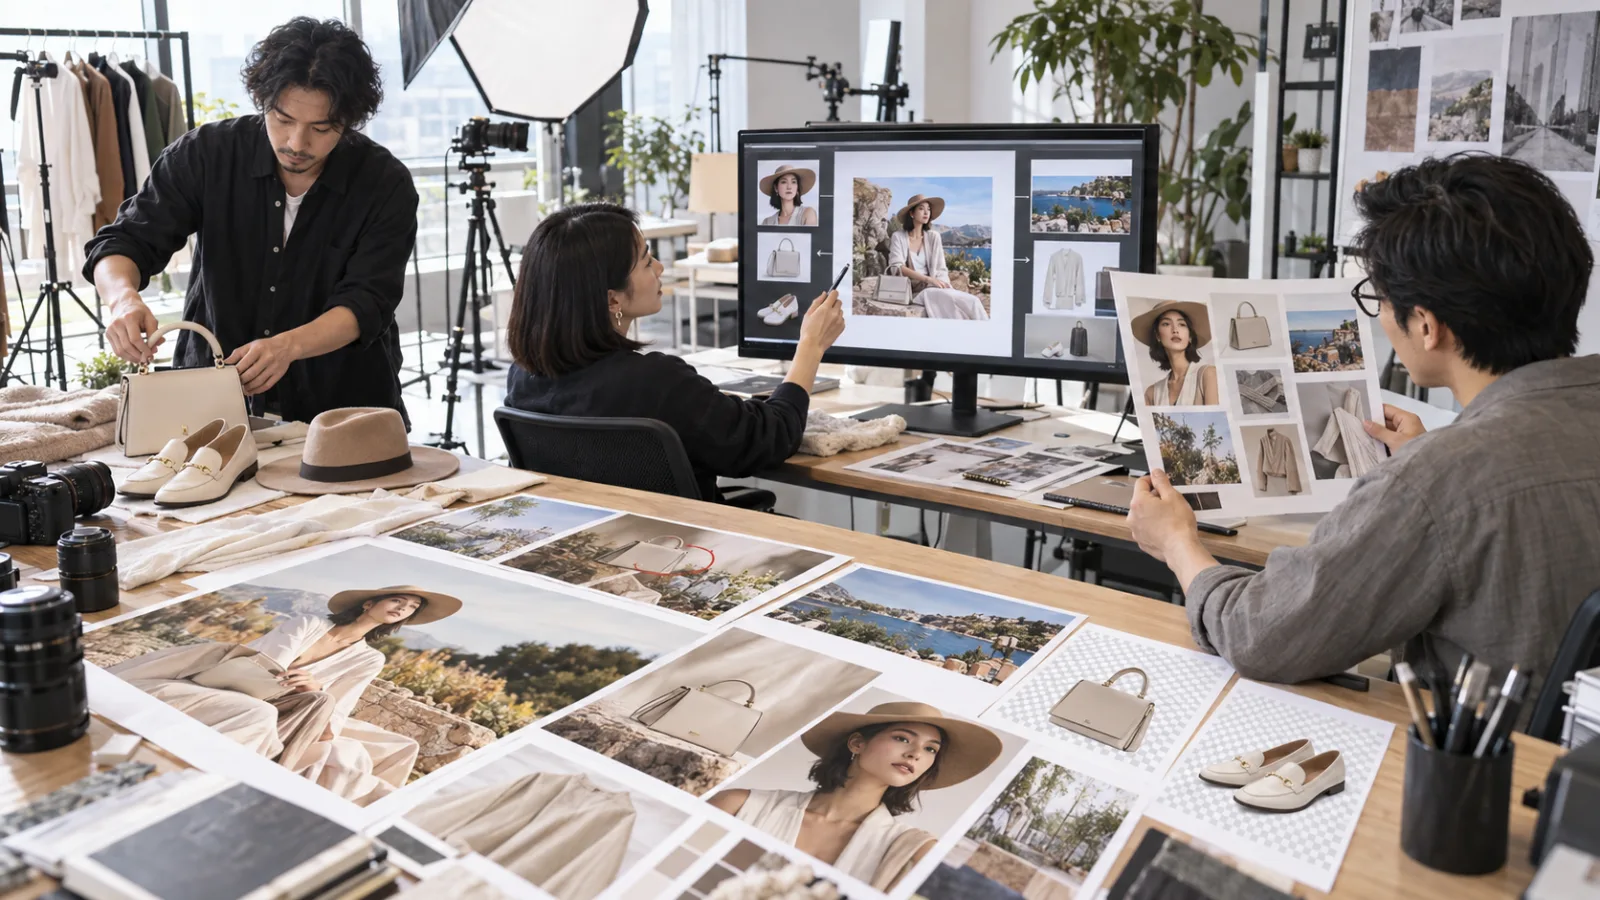
例如你想做一张品牌形象照。
可以分别提供:
第 1 张:
人物。
第 2 张:
上衣。
第 3 张:
裤子。
第 4 张:
鞋子。
第 5 张:
包包。
第 6 张:
帽子。
第 7 张:
拍摄场景。
再要求 AI:
把这些元素组合成一张完整照片。
官方展示的案例里,
甚至直接把:
人物、
衣服、
鞋子、
包包、
帽子
从不同图片组合成一个完整 Outfit。
这和以前:
只给一张参考图,再用文字描述其他元素
很不一样。
为什么多 Reference 很重要?
因为文字描述不一定能精准保存:
商品比例。
人物特征。
服装细节。
品牌设计。
例如你跟 AI 说:
「黑色皮革手提包。」
它可能生成一个:
看起来合理的黑色皮包。
但你真正要的是:
这一个商品。
这时候图片 Reference 的价值就比文字高很多。
所以真正实用的 Workflow 会慢慢变成:
人物 Reference
+商品 Reference
+服装 Reference
+场景 Reference
+文字 Instruction。
而不是所有东西都靠 Prompt 猜。
第二个功能:不要整张重画,只改指定区域
Qwen-Image-2.1 也支持:
Local Editing。
你可以用:
Circle、
Painted Annotation、
Mask
指出:
哪个地方要改。
例如一张人物照片里:
圈住手表。
要求:
「移除手表。」
圈住头发。
要求:
「改成深棕色。」
选取衣服。
要求:
「换成米白色衬衫。」
真正的目的不是让 AI:
再生一张「差不多的人」。
而是:
把修改范围缩小。
这对:
商品图、
人物形象照、
广告素材、
社区图片
都比较实用。
但「只圈这里」不代表其他地方一定 Pixel-level 完全不变
这一点还是要保留现实。
Image Generation Model 本质上仍然是在重新推理图片。
Local Edit 的目标是:
更精准控制修改范围。
不是保证:
其他每一个 Pixel 都 Bit-for-bit 完全相同。
所以如果是:
Logo、
精确商品包装、
法律文档、
医疗图片、
需要完全固定的设计元素,
修改后仍然要:
重新比对。
不要只因为用了 Mask,
就认定其他地方一定没有变。
第三个功能:直接生成透明背景
这个功能其实非常实用。
Qwen-Image-2.1 原生支持:
RGBA Transparent Image。
也就是图片本身就可以有:
Alpha Channel。
简单讲:
背景可以直接是透明的。
例如你可以生成:
Sticker。
商品素材。
人物 Cutout。
演示文稿插图。
网站 Icon。
视频叠加元素。
以前常见流程可能是:
生成图片
↓
再丢到另一个工具去背
↓
修边
↓
输出 PNG。
现在模型可以直接:
从生成阶段处理 Transparency。
已经有照片,也能直接抽出主体
透明背景不只用在:
从零开始生成。
官方还特别列出:
Subject Extraction。
例如你有一张:
咖啡杯放在桌上的照片。
可以要求模型:
留下咖啡杯,
把其他背景移除,
输出透明素材。
对:
电商、
广告、
演示文稿、
社区设计
都很实际。
因为很多任务作真正花时间的不是:
「创作一张艺术图。」
而是:
把素材整理成能继续使用的格式。
第四个功能:原生支持 2K
官方目前列出的 Native Resolution 是:
2K。
例如 1:1:
2048 × 2048。
也提供:
4:3、
3:4、
3:2、
2:3、
16:9、
9:16
等建议尺寸。
这对内容创作者很实用。
因为同一个 Model 就能直接处理:
Instagram Square。
Website 16:9。
Reels/Shorts 9:16。
直式海报。
横式广告。
不用每次先生成正方形,
再另外裁切。
但 7B 不代表整套模型只有 7B
官方很强调:
7B Parameters。
不过这里要看完整说法。
7B 指的是:
Visual Generation Component。
也就是内核图像生成 Transformer。
Qwen-Image-2.1 另外使用:
Qwen3-VL 8B
作为 Text Encoder,
负责理解:
文字 Instruction
和:
Reference Images。
所以不要把:
「7B Visual Generation Component」
简化成:
整套系统总共只有 7B。
比较准确的说法是:
Qwen 希望把主要图像生成部分做得更 Compact,
同时保留多 Reference 与 Editing 能力。
为什么它要做得比较小?
Image Model 很容易遇到一个现实问题:
越强,GPU 越吃。
如果每一次:
生成、
改图、
多 Reference
都需要非常大的 Compute,
实际部署成本会很高。
Qwen-Image-2.1 使用:
Mixed-granularity Attention
和:
Prefix KV Cache Reuse。
尤其多图 Editing 时,
Reference Images 与文字 Context 不需要每一个 Denoising Step 全部重新计算。
简单理解就是:
已经看过的 Reference,不要一直重新读。
目的是减少重复运算。
Prompt 太短,官方甚至另外准备 AI 帮你重写
另一个很有意思的功能是:
Qwen 这次还另外发布两个:
Prompt Rewriting Models。
一个专门处理:
Text-to-Image。
另一个处理:
Image Editing。
例如你只写:
「把天空改成夕阳。」
Prompt Rewriter 可以先帮你展开成更完整的描述:
哪些地方要改。
夕阳的光线如何。
哪些主体应保持。
输出比例如何处理。
也就是:
先让一个 AI 把你的需求整理好,再交给图片 AI。
这个方向很值得注意。
因为一般用户不一定需要自己背:
几十种 Prompt 技巧。
模型前面可以再加一层:
Instruction Translator。
那现在要去哪里用?
目前最直接的方式主要有几种。
如果只是想体验:
官方 Repository 提供 Hugging Face Demo 入口。
ModelScope 也支持:
Online Generation。
如果自己有 GPU,
可以使用:
Diffusers。
Qwen-Image-2.1 在发布当天就取得 Day-0 Support。
如果平常习惯可视化 Workflow,
也可以使用:
ComfyUI。
ComfyUI 同样在发布当天就原生支持:
Text-to-Image
和:
Image Editing。
所以它不是只有:
「Weights 放出来,大家自己想办法。」
相关生态工具已经同步接上。
一般用户需要自己装吗?
不一定。
如果只是:
测试效果、
偶尔生图,
先使用 Online Demo 比较简单。
Local Deployment 比较适合:
想控制 Workflow、
大量生成、
研究 Model、
需要自己管理素材、
或本来就会用 ComfyUI/Diffusers
的人。
因为自己跑还涉及:
GPU VRAM、
Python Environment、
Model Weights、
Storage、
Inference Settings。
所以「公开权重」不等于:
下载一个 App 就能直接跑。
最大的提醒:公开权重,不等于自由商用
这是今天最不能忽略的一点。
Qwen 官方把 Qwen-Image-2.1 称为:
Open-source Image Generation Model。
模型 Weights 也确实公开下载。
但它目前不是一般常见的:
Apache 2.0
License。
而是:
Qwen Research License Agreement。
这份 License 明确写出:
目前授权是:
Non-commercial Research/Evaluation。
如果要把 Qwen-Image-2.1 Materials 用于:
Commercial Purpose,
需要另外取得:
Commercial License。
所以:
可以下载模型,
不等于:
可以直接拿来替客户做商业产品。
这两件事一定要分开。
那生成出来的图片也完全不能商用吗?
这里不要过度简化。
官方 License 的主要限制,
明确针对的是:
Qwen Materials
以及利用这套 Materials 的 Commercial Use。
但实际商用一张生成图片时,
还可能同时涉及:
你是透过哪个 Service 使用、
该服务自己的 Terms、
Reference Image 权利、
人物肖像、
Trademark、
Copyright
等问题。
所以最安全的做法不是看到:
「Open-source」
就直接下结论:
所有 Output 随便商用。
如果你准备把它放进:
收费服务、
客户项目、
商业产品、
大量 API Workflow,
先确认:
你使用的模型/平台到底适用哪份 License。
Qwen-Image-2.1 真正值得看的不是 Benchmark
今天这个工具最实用的地方,
其实可以浓缩成四件事:
多张 Reference
让 AI 不必只靠文字猜人物、商品与风格。
Local Editing
让修改范围变得更明确。
Native Transparency
少掉额外去背流程。
Unified Model
不用每做一个步骤就换一个不同 Model。
这意味着 AI 图像工具正在从:
「帮我生成一张漂亮的图。」
往:
「帮我完成一段图片制作流程。」
移动。
对真正做内容的人来说,
后者才更有价值。
今天,和 AI 一起进步一点。
每天学会一个 AI 技巧。
每天节省一点时间。
每天提升一点能力。
SasaDaily,陪你一起成长。
推荐阅读
AI 晚报|2026/08/01:欧盟明天开始要求 AI 内容揭露身分,生成图片、深伪视频与聊天机器人进入「必须说清楚」时代