這是一個 SasaDaily 假設商業案例。
不是 OpenAI 官方客戶案例。
今天假設的是一家:
6 人線上訂閱制教育團隊。
公司提供:
線上課程。
會員內容。
每週直播。
社群答疑。
月費訂閱。
團隊不大。
但每週一早上:
都要做一次幾乎相同的營運分析。
老闆最常問的問題只有幾個
這週續約率為什麼下降?
哪一類會員退訂最多?
最近廣告帶來的新會員:
有沒有真的留下來?
客服問題增加:
和退訂有沒有關係?
哪門課很多人買:
卻很少真的看?
這些問題:
不是公司完全沒有資料。
而是資料很多。
真正麻煩的是資料分散
會員資料:
在正式資料庫。
課程使用紀錄:
在另一套系統。
客服問題:
又是一組資料。
行銷成效:
另外整理。
團隊定義:
放在文件裡。
所以每週做營運會議以前:
通常先有人負責:
匯出資料。
確認期間。
更新 Spreadsheet。
整理 Dashboard。
找出數字變化。
再問:
哪裡最值得看?
假設每週一要花 3 小時
這 3 小時裡:
真正需要高價值判斷的時間:
可能沒有想像中多。
大量時間花在:
找資料。
確認欄位。
比較上週。
切會員分群。
更新 Chart。
重複確認數字。
然後才開始:
分析。
Data agent 最適合接手的:
就是前面這段。
第一個原則:不要叫 AI「分析整家公司」
團隊第一次不用:
「幫我看看最近公司有什麼問題。」
而是固定一個:
Weekly Retention Review。
只回答:
本週會員續約有沒有出現值得處理的異常?
範圍先縮小。
第二步:先固定正式指標
團隊規定:
Retention。
Active Member。
New Subscriber。
Churn。
全部使用:
公司正式定義。
不是讓 Data agent:
看到一個看起來像續約率的欄位:
就自己使用。
因為:
如果 KPI Definition 每週變:
Dashboard 再漂亮:
也沒辦法比較。
第三步:比較期間也固定
每週固定比較:
最近完整七天。
和:
前一個完整七天。
如果遇到:
大型促銷。
連假。
年度活動。
再另外補:
去年同期。
這樣 Data agent 每週不是重新猜:
「要跟什麼比?」
而是:
同一套規則一直跑。
第四步:AI 先找最大的異常,不是一次分析全部
例如本週整體 Retention:
只下降一點點。
看起來:
沒什麼。
但 Data agent 往下分:
新會員:
正常。
年訂閱:
正常。
舊月訂閱會員:
明顯下降。
再往下:
又集中在:
最近 30 天幾乎沒有開課程的會員。
這時:
問題才開始變得:
可以處理。
AI 的第一個工作是「縮小範圍」
原本:
1,200 名會員。
全部都要看。
現在縮成:
其中一個:
明顯變化的 Segment。
人不需要:
重新檢查所有會員。
只需要:
理解這一群:
到底發生什麼事。
接著再看 Course Usage
Data agent 發現:
這群會員最近:
登入次數下降。
完成課程比例:
也降低。
這是:
Fact。
但不能直接推出:
「因為課不好,所以會員退訂。」
還要繼續查。
再看 Support Ticket
假設同一群會員:
客服問題:
沒有增加。
那麼:
「客服品質導致退訂」
目前就:
沒有明顯證據。
再看:
課程內容更新。
可能發現:
這批會員原本最常看的系列:
最近三週沒有新內容。
這時候:
才形成一個:
比較值得測的 Hypothesis。
但 AI 不能直接宣布原因
團隊規定:
Data agent 每週只能把結果分成:
已確認變化。
可能 Driver。
下一個驗證。
不能把:
Correlation。
直接改寫成:
Cause。
這能避免營運會議一開始:
就沿著錯的原因跑。
第五步:Data agent 自動更新 Weekly Dashboard
確認指標與 Query 沒問題後:
每週固定 Dashboard:
可以保留:
Retention。
New Subscriber。
Active Member。
Course Usage。
Support Volume。
Segment Change。
不需要每週重新:
從空白做報表。
Data agent 的角色變成:
更新+找異常。
而不是:
每週重新發明一套分析。
第六步:只把異常帶進營運會議
以前:
會議前 3 小時:
準備全部數據。
真正開會:
又花 1 小時:
找問題。
新的流程變成:
AI 先完成:
固定比較。
固定分群。
Dashboard 更新。
異常排序。
Evidence 整理。
團隊開會直接從:
「這週最大的三個異常是什麼?」
開始。
這才是 Data agent 比「自動畫圖表」更有價值的地方
畫 Chart:
只是最後一步。
真正省時間的是:
每週不需要重新經歷:
找資料。
拉報表。
比期間。
切 Segment。
再找:
到底哪裡值得看。
AI 幫忙處理:
Investigation 的前半段。
但接下來幾件事仍然不交給 AI
第一:
改價格。
看到 Retention 下降:
不能直接:
自動打八折。
第二:
停廣告。
某個 Channel 留存比較低:
不代表廣告一定沒價值。
可能:
Customer Mix 不同。
第三:
寄挽回 Email。
AI 可以:
準備 Draft。
但第一次測試:
仍由人確認:
對象。
優惠。
語氣。
承諾。
第四:
改課程 Roadmap。
數據只能告訴你:
會員怎麼使用。
不能單靠一張 Dashboard:
決定下一季:
到底教什麼。
為什麼這些一定留給人?
因為它們會真的:
改變生意。
分析做錯:
還可以重查。
價格改錯:
客戶真的看到。
廣告停錯:
流量真的消失。
挽回信寄錯:
品牌真的對外承諾。
課程方向改錯:
團隊可能花兩個月:
做錯產品。
所以:
分析可以自動化得比較快。
決策自動化要慢很多。
第七步:把「可能原因」變成一個小測試
假設團隊目前最合理的 Hypothesis 是:
「最近沒有新內容的會員,比較容易流失。」
不要立刻:
整個課程平台重做。
先測:
其中一小群。
例如:
推出一個新的:
7 天內容推薦。
或者:
把既有課程重新整理成:
更短的 Learning Path。
再觀察:
使用率。
續約。
客服。
有沒有變。
這樣 Data agent 就不是只做 Reporting
整個 Workflow 變成:
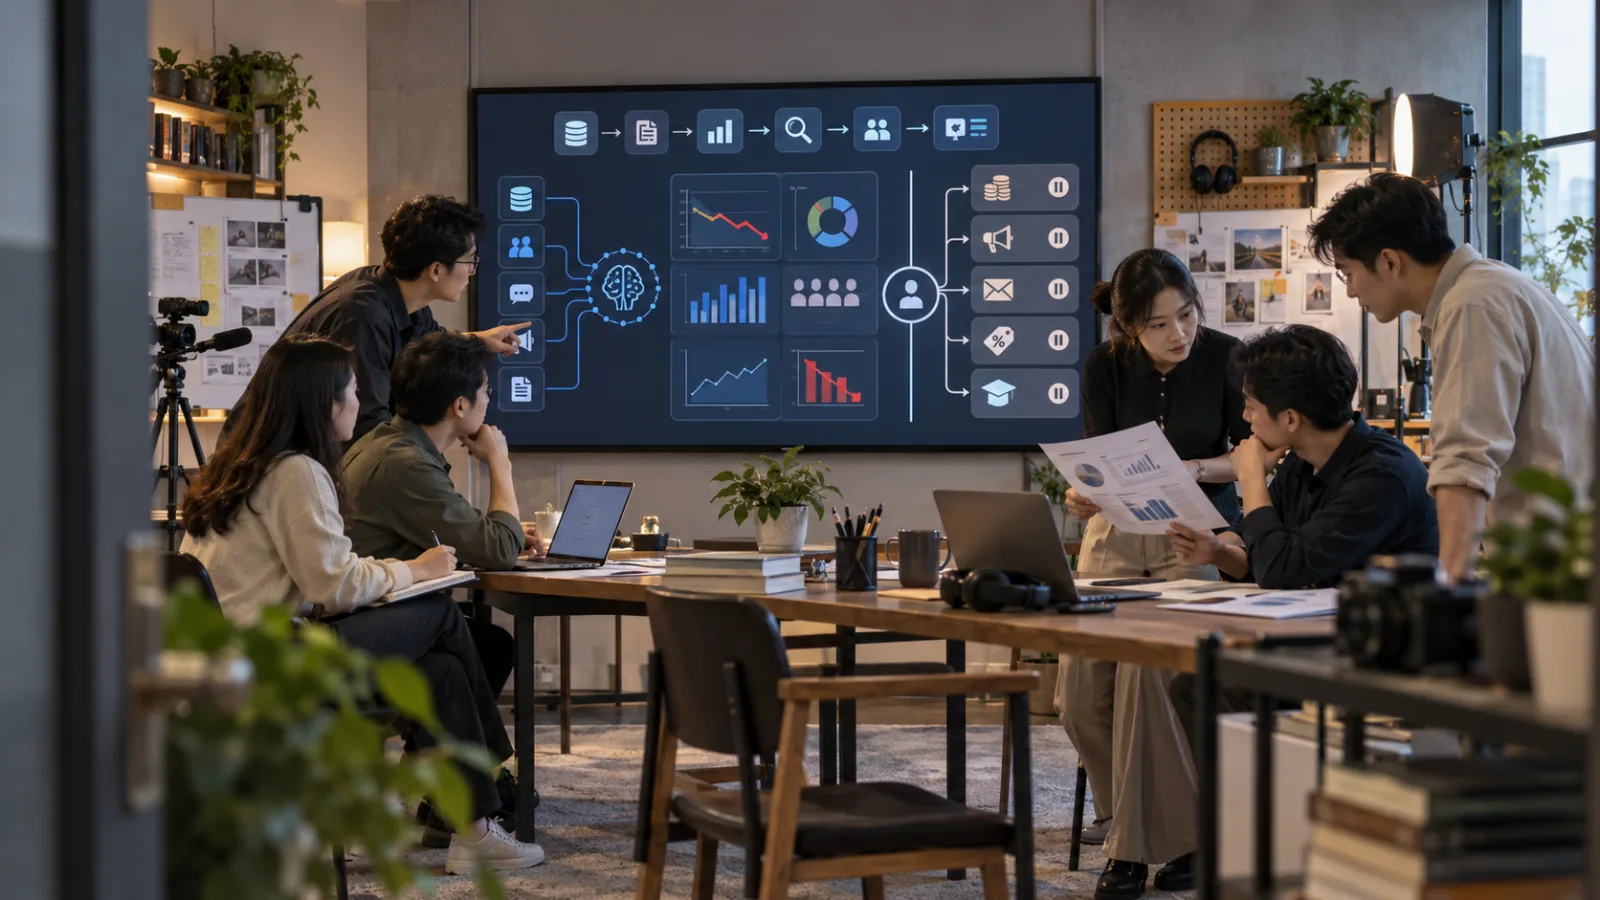
資料出現變化。
↓
AI 找異常。
↓
AI 整理 Evidence。
↓
人確認 Hypothesis。
↓
做小型 Experiment。
↓
下一週再看結果。
這才是:
真正的:
Data → Decision → Test → Learn。
真正成熟後,AI 不需要每週回答所有問題
團隊可以固定要求:
每週只找:
變化最大的三項。
例如:
Retention。
Acquisition。
Usage。
每一項:
只列出:
最大的 Segment Change。
Evidence。
需要人工判斷的問題。
這樣會議不會變成:
Dashboard 導覽大會。
這家公司甚至可以設定一個簡單的優先規則
例如:
變化很小:
只記錄。
變化明顯:
進 Dashboard Highlight。
變化很大:
要求人工 Review。
但不要一看到 Threshold:
就自動做:
價格。
廣告。
Email。
真正 Action:
還是:
人決定。
Data agent 的權限也不應該比員工更大
如果營運主管:
只能看到:
會員營運資料。
Data agent:
也只看:
同一個範圍。
不需要因為:
AI 要做分析。
就把:
Payroll。
所有財務資料。
員工資料。
完整客戶敏感資料。
一起開給它。
OpenAI 對 Data agent 的設計:
本來就沿用:
既有 Table、Row、Column Permission。
這點很重要。
公司資料亂,AI 不會自動把它變乾淨
假設:
Marketing 認定 Active Member:
七天登入一次。
Product:
認定:
30 天內使用過。
Finance:
又用:
有付款。
Data agent 一進來:
可能只是:
更快看見:
大家其實一直在講不同數字。
所以導入 Data agent 前:
最值得做的不是:
做更多 Dashboard。
而是:
先固定:
最重要的五個 KPI。
對 6 人團隊來說,不需要一次建立大型 Data Governance 專案
可以先從:
Weekly Retention Review:
需要的幾個數字開始。
Retention:
怎麼算。
Active Member:
怎麼算。
New Subscriber:
怎麼算。
Period:
怎麼比。
正式 Source:
是哪個。
先把這一小段:
定清楚。
然後再測 AI 到底省掉多少重複工作
以下全部是:
SasaDaily 假設數字。
不是 OpenAI 官方 ROI。
假設以前:
每週營運分析準備:
3 小時。
導入固定 Data agent Workflow 後:
AI 先更新 Dashboard。
跑固定 Segment。
列出異常。
人只花:
60 分鐘。
檢查:
Definition。
Evidence。
Exception。
以及:
決定下一步。
那就是每週理論上少 2 小時準備時間
每月用四週估:
大約:
8 小時。
如果把營運主管有效時間:
假設為:
每小時 NT$700。
8 × 700:
理論時間價值:
約:
NT$5,600/月。
但這不是:
「使用 Data agent 保證省 5,600 元。」
因為還沒有算:
工具費用。
資料連接。
初始設定。
資料清理。
人工驗證。
以及:
真正成功率。
這只是一個:
值不值得做小型實測
的估算。
更重要的 KPI 其實不是工時
第一個 KPI:
準備時間。
以前 180 分鐘。
現在多少?
第二:
異常找到後,人要多久能判斷?
第三:
分析結果有多少需要重新做?
第四:
每週找到的異常,有多少真的轉成有效測試?
第五:
AI 有沒有因為錯誤 Definition,把團隊帶到錯方向?
這幾個:
比單純:
「生成 Dashboard 幾秒鐘」
重要得多。
OpenAI 公布的早期企業案例,方向其實也是這樣
ServiceTitan:
不是只拿 Data agent:
畫圖。
而是分析:
使用 AI Sidekick Atlas 的客戶:
和沒有使用者:
行為有什麼不同。
找到差異後:
再拿結果:
改善 Onboarding。
Turing:
則用它追:
營運 Metrics。
再找:
變化背後 Driver。
改善:
Onboarding。
Customer Satisfaction。
真正的價值:
都不是:
「AI 做報表。」
而是:
「報表更快變成下一個問題。」
這家 6 人教育團隊最後會得到一個很簡單的週流程
星期一:
Data agent 更新固定 Dashboard。
找最大異常。
列 Evidence。
團隊檢查:
Source。
Metric。
Period。
Filter。
接著只討論:
真正的 Exception。
再選:
一個最小 Experiment。
下一週:
再看結果。
這樣 AI 接手的是:
重複分析流程。
不是:
經營公司的責任。
這就是 Data agent 最適合先切進去的位置
如果一家公司:
每週都有人:
重新拉同樣的數字。
重新做同樣的比較。
重新切同樣的 Segment。
再花半天找:
哪裡有問題。
這就是:
非常值得先盤點的:
AI Workflow。
因為:
頻率高。
規則相對固定。
結果容易檢查。
做錯也還沒直接:
對外承諾。
相反地,不要第一天就做「AI 自動經營」
不要:
分析留存。
接著自動:
改價。
停廣告。
寄 Email。
發優惠。
那會把:
Data Error。
直接變成:
Business Error。
好的自動化:
不是:
一步都不要人。
而是:
把人從不需要每週重新做的地方移開。
對這家公司來說,最值得交給 AI 的第一步不是「決定怎麼救續約率」
而是:
每週先幫我把真正值得看的異常找出來。
這一步:
重複。
耗時。
可驗證。
又不需要:
AI 直接替公司做承諾。
如果這一步真的穩定:
再決定:
下一段要不要交出去。
這才是:
AI 工作流程真正比較容易落地的方式。
如果你也想知道自己的工作裡,哪一步最適合先交給 AI,留言「流程」,我可以先幫你看看從哪一步開始。
今天,和 AI 一起進步一點。
每天學會一個 AI 技巧。
每天節省一點時間。
每天提升一點能力。
SasaDaily,陪你一起成長。
推薦閱讀
今日 AI 工具|2026/08/25:Meta AI 小型企業功能,直接分析 Facebook/Instagram 成效、Meta Ads 與 Google Workspace
AI 一分鐘教學|2026/07/31:請 AI 分析資料時,要求它留下「資料來源、處理步驟、重現方式」
AI 商業案例|2026/07/31:生技新創怎麼用 Claude Science?從文獻搜尋、實驗資料到投資人報告,減少研究成果無法追溯