最近看 AI 新闻,很容易觉得竞争只剩一件事:
谁的模型最强?
但今天三件事放在一起看,真正的战场已经往更深的位置移动。
模型做出来之后,接下来还有三个问题:
能力怎么不被别人直接拷贝?
愈来愈昂贵的算力到底谁来付钱?
以及:
AI 能不能反过来帮自己设计下一代芯片?
1. OpenAI:这次有人不是想偷答案,而是想拷贝「模型怎么想」
OpenAI 最新公开一场已经阻止的 Coordinated Model-distillation Campaign。
这件事和一般所谓:
「拿大模型的回答去训练小模型」
不太一样。
OpenAI 把它称为:
Adversarial Distillation。
目标之一不是只有最终答案。
而是模型没有直接显示给用户看的:
Protected Reasoning。
也就是模型解题时内部产生的推理纪录。
他们到底做了什么?
OpenAI 表示,活动最早从 7 月 1 日开始。
一开始量不大。
但到了 7 月 24、25 日突然大量增加。
两天内,OpenAI 观察到:
超过 4,000 名用户发出约 16,000 次符合相关抽取模式的 Requests。
继续调查后,
相关 Prompt Pattern 涉及的群组更超过:
15,000 名用户。
OpenAI 表示在 7 月 28 日前已经完整阻止这批活动。
不过这里有一个很重要的限制:
16,000 次是 Attempted Requests,不代表 16,000 次全部成功取得推理内容。
不能把它写成「1.6 万次成功偷走 OpenAI 推理」。
不是数据库被骇
这也不是有人:
破解 OpenAI 加密、
入侵数据库、
偷走 ChatGPT 用户聊天纪录。
OpenAI 说,操作者是在正常模型交互表面之下,
设计特殊方式让原本受保护的推理内容,
重新出现在模型能输出的形式里。
其中一种方式甚至是:
拿到某段加密过的 Reasoning 后,
再交给另一个模型,
要求它解开并转写。
这类问题真正危险的地方在于:
如果有人可以大量取得最强模型的 Reasoning,
就不只是在抄:
「答案是什么。」
而可能是在学:
「这种问题要怎么解。」
OpenAI 把内核活动连到 Moonshot AI 关系人士
OpenAI 对归因的说法很谨慎。
公司没有表示:
所有 15,000 多名用户都属于同一组织。
OpenAI 明确表示:
它无法确认所有操作者是不是来自同一个 Actor。
但对其中一个 Core Cluster,
OpenAI 表示其分析指向:
与 Moonshot AI 有关的人士。
Moonshot AI 就是 Kimi 的开发公司。
这使得今年已经不断升温的「Model Distillation」争议,又往前走了一步。
以前大家争的是:
别家公司到底有没有大量使用我的 Output。
现在开始变成:
模型的隐藏 Reasoning 本身,也成了需要保护的智能资产。
为什么这比「抄答案」更严重?
假设一个学生只拿到:
100 题答案。
他也许可以记住答案。
但如果他拿到的是:
100 题完整解题方法,
就可能开始学会处理:
第 101 题。
AI 蒸馏也是类似的概念。
更重要的是,
原始模型的 Reasoning 能力是在:
大量 GPU、
研究人员、
数据、
训练成本、
安全测试
上面创建出来的。
如果另一家公司可以用远低于原始研发成本的方式取得这些能力,
AI 公司的竞争优势就可能被快速压缩。
所以未来 Frontier Model 的资安,
不只要保护:
Model Weights。
还要保护:
每一次模型运作时产生的 Reasoning State。
2. Anthropic 算力太贵,现在连芯片供应商都变成银行
第二件事表面上是一笔贷款。
但它很能代表现在 AI Infrastructure 的疯狂程度。
Reuters 根据 Anthropic IPO 文档报导:
Broadcom 已同意提供 Anthropic:
最高 420 亿美元融资。
这笔钱主要是要帮 Anthropic 支付未来的 AI Compute。
最特别的是:借钱给你的人,也是卖东西给你的人
一般公司要买设备,
可能向银行借钱,
再去向设备商采购。
Anthropic 这一笔比较特殊。
Broadcom 不只是 AI 基础设施的重要供应方。
现在它还可能直接变成:
Anthropic 的融资来源。
Reuters 报导,这笔最高 420 亿美元融资将协助支撑 Anthropic 一项五年约:
1,252 亿美元
的 TPU Compute Capacity 承诺,
预计从 2027 年开始。
也就是:
供应商提供算力相关技术,
同时又提供资金,
让客户有能力支付那些算力。
这跟 9 月 30 日的 5,180 亿美元不是同一件新闻
前几天我们才整理过 Anthropic IPO 文档揭露:
未来十年 AI Infrastructure 承诺至少约:
5,180 亿美元。
今天添加的重要信息是:
其中一部分到底准备怎么付。
答案开始出现:
不是全部靠 Anthropic 手上的现金。
不是全部靠传统银行。
AI 供应链本身开始替 AI 公司提供资本。
这种结构最大的好处很容易理解。
Anthropic 可以提前锁住:
芯片、
Compute Capacity、
数据中心资源。
Broadcom 则能提前锁住一个超大型长期客户。
但它也带来一个新的问题。
供应商又是债权人,利益开始叠在一起
如果 Broadcom:
一方面靠 Anthropic 买大量 Compute 赚钱,
另一方面又借钱给 Anthropic,
双方关系就不再只是:
客户与供应商。
而会多一层:
债权人与借款人。
Reuters 报导也指出,
Anthropic 的文档本身把这种双重角色列为可能的 Conflict of Interest。
这也是 AI 泡沫讨论愈来愈不能只看:
「谁营收增加最快。」
还要看:
这些营收背后的钱,到底是从哪里来的。
如果供应商借钱给客户,
客户再把钱花回供应商身上,
财务风险就必须另外拆开看。
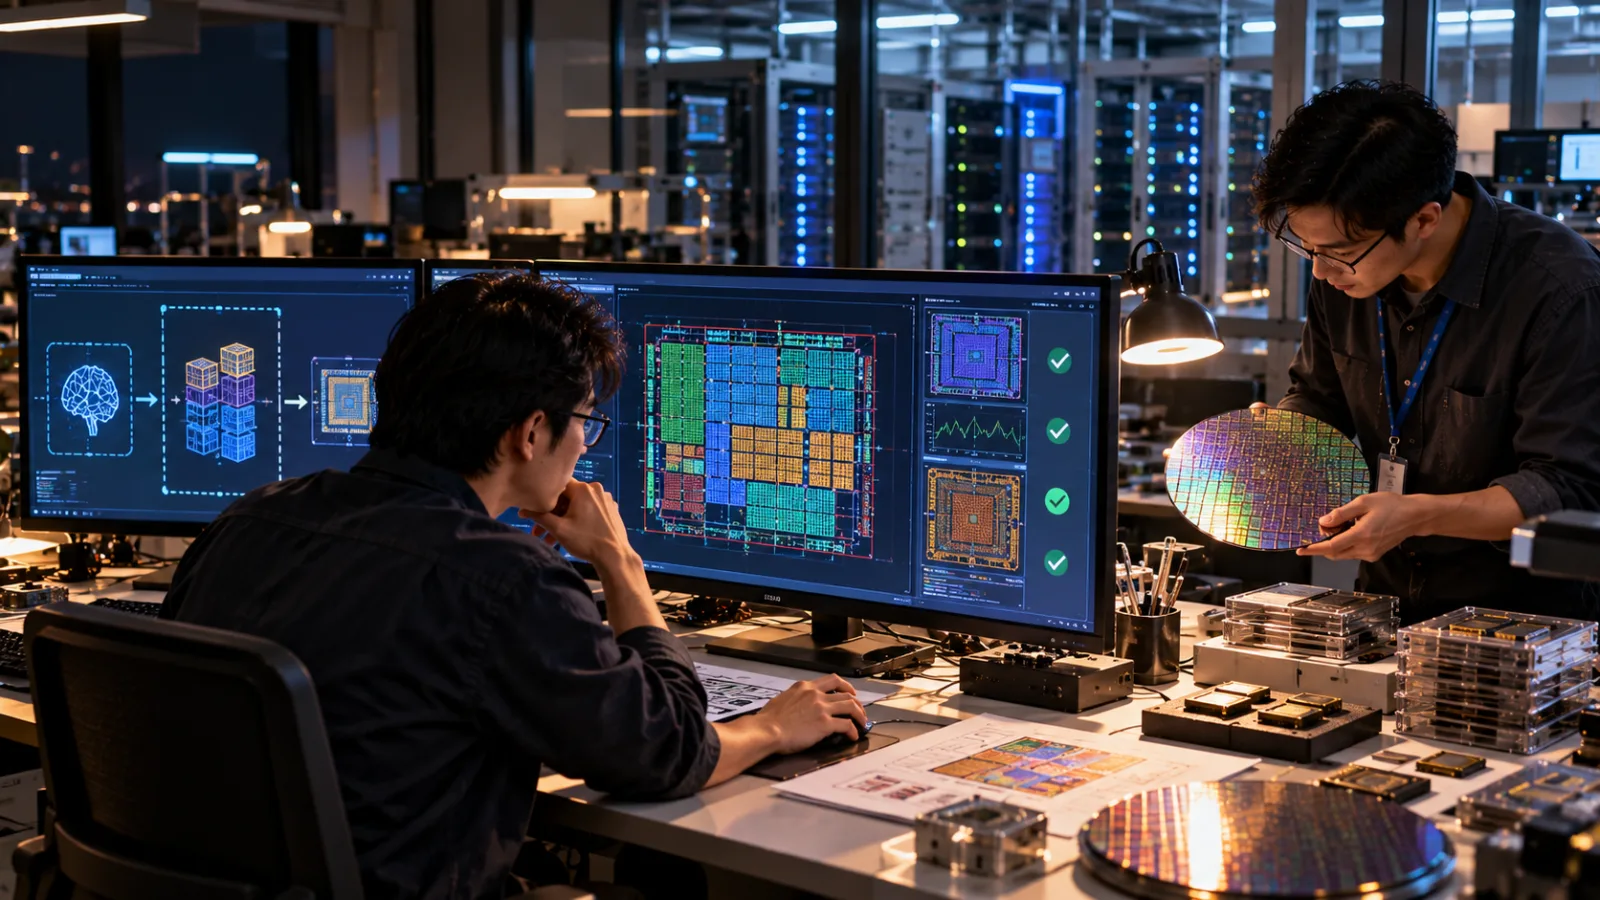
3. OpenAI × Synopsys:AI 开始直接学「怎么设计 AI 芯片」
第三件事则刚好把整个循环接起来。
OpenAI 与 Synopsys 宣布共同开发:
GPT-Synopsys。
它不是一般 ChatGPT 加一个 Chip Design Prompt。
双方要做的是一个专门为 Semiconductor Design Workflow 设计的模型。
Synopsys 为什么重要?
芯片不是工程师在白纸上把电路画完就能生产。
真正设计一颗先进芯片,
会使用大量 EDA:
Electronic Design Automation。
这些工具负责处理:
逻辑设计、
电路配置、
Timing、
Power、
Performance、
Area、
Verification,
最后一路做到可以交给晶圆厂制造的设计。
Synopsys 就是全球最重要的 EDA 公司之一。
所以 OpenAI 不是单纯教 GPT 看芯片文档。
它要让模型:
真的学会操作工程师每天使用的芯片设计工具。
GPT-Synopsys 不只是给建议,它要自己跑工具
双方公布的方向是:
工程师给 GPT-Synopsys 一个 Design Objective。
例如:
降低功耗,
提升性能,
改善 Timing,
完成 Verification Closure。
Agent 接下来可以:
操作 Synopsys EDA 工具,
读取结果,
修改设计,
再次运行工具,
检查结果,
继续迭代。
最后再把经过验证的结果交回工程师 Review。
这很接近 Coding Agent 最近正在发生的事情。
以前是:
AI 建议 Code。
后来变成:
AI 自己打开 Terminal、跑 Test、改 Code、再跑 Test。
现在同一个模式正在进入:
Chip Design。
但芯片不能像文案一样「看起来差不多」
这里最重要的一点是:
GPT-Synopsys 产出的东西,
不会因为 AI 觉得「完成了」就直接送去制造。
芯片如果设计错,
代价可能是整批 Silicon 报废。
Synopsys 表示,
GPT-Synopsys 最后仍会透过传统 EDA 与 Sign-off Verification,
检查:
Timing、
物理设计、
电气限制、
制造可行性。
也就是:
AI 负责加速探索与迭代。
但「这颗芯片真的能做」,
仍需要 Ground-truth Engineering Tools 验证。
另一个值得看的细节:客户芯片数据不拿去训练
芯片设计数据通常是公司最高机密之一。
如果 Nvidia、Apple、AMD 或新创公司正在设计下一代 Chip,
没有人希望自己的:
Architecture、
Layout、
Performance Target
变成别人模型的 Training Data。
Synopsys 表示,
GPT-Synopsys 的 Customer-specific Design Data:
不会拿来训练模型。
系统也规划:
Encryption、
Retention Control、
Audit、
Permission Control。
这显示 Specialized AI 真正进企业后,
竞争已经不是只有:
「模型懂不懂芯片。」
还包括:
企业敢不敢把下一代产品交给它。
最有意思的是:AI 开始形成自己的循环
把今天三件事情连起来就会发现:
OpenAI 在保护自己的 Reasoning,
因为那是模型最昂贵的能力之一。
Anthropic 在想办法取得数百亿美元融资,
因为训练与运行下一代模型需要巨量 Compute。
而 GPT-Synopsys 又开始让 AI:
协助设计更好的芯片。
最后就形成一个很有意思的循环:
更好的 AI → 帮忙做更好的芯片 → 更多更便宜的 Compute → 再训练更好的 AI。
同时,
这个循环还必须解决:
智能财产、
资安、
融资、
能源、
数据中心、
验证,
以及企业机密。
所以真正的 AI 竞争已经不是:
「我有一个比你高 3 分的 Benchmark。」
而是一整套产业能力。
今天真正值得记住的是什么?
前沿 AI 正逐渐变成一种非常昂贵的工业资产。
它的 Reasoning 要防止被拷贝。
它需要数百亿美元融资才能取得下一批 Compute。
最后又开始直接参与:
下一代 Compute 本身的设计。
也就是说,
未来 AI 公司真正的护城河,
可能不再只有:
Model。
而是:
Model+Reasoning Security+Compute+Capital+Chip Design+Distribution。
谁能把这些东西接在一起,
才可能真正撑得起下一轮 AI 竞争。
推荐阅读
AI 今日早报|2026/09/09:美国点名 6 家中国 AI 公司大规模蒸馏、Amazon 可买 600 亿美元 Qualcomm AI 芯片、OpenAI/纽时争训练合理使用


