以前公司談 AI 資安:
最常問的是:
資料會不會外洩?
模型會不會被攻擊?
Prompt 裡有沒有機密?
AI 回答會不會出錯?
但 AI Agent 開始進入企業後:
問題正在變。
因為它不只:
回答。
它開始:
做事。
開網站。
讀 Email。
存取 Database。
修改文件。
呼叫 API。
執行 Command。
甚至:
控制真實設備。
所以今天南韓公布的一個動作:
非常值得看。
南韓準備重新寫 AI Security Guide
Reuters 今天報導:
南韓科學技術情報通信部旗下的:
Korea Internet & Security Agency。
也就是:
KISA。
正在更新:
既有的:
AI Security Guide。
新版會特別處理:
Agentic AI。
也就是:
能夠在較少人工監督下:
自行執行多步驟任務的 AI Agent。
重點不只是增加幾條資安建議
KISA 告訴 Reuters:
新版 Guide:
將聚焦企業導入:
Agentic AI Service
之後產生的新型 Security Issue。
並提供:
一套:
Risk Checklist。
更值得注意的是:
KISA 表示:
新版內容還可能包括:
適用於:
Physical AI
的共同控制措施。
Physical AI 為什麼特別重要?
一般 Chatbot:
回答錯。
最常見的結果可能是:
你看到一段錯誤資訊。
但 Physical AI:
可能真的連接:
Robot。
Machine。
Camera。
Vehicle。
Industrial Equipment。
也就是:
AI 的錯誤。
不再只停在:
螢幕上。
以前最危險的是「它說錯」
未來更危險的可能是:
「它做錯。」
例如:
AI 誤判一封 Email。
只是:
回答錯。
和:
AI 誤判一封 Email:
接著自己:
修改 CRM。
刪掉資料。
寄出訊息。
執行 Command。
完全不是:
同一個風險等級。
所以 Agentic AI:
真正帶來的新問題:
不是:
模型突然比較邪惡。
而是:
模型手上開始有工具。
一個 AI Agent 的風險,可以非常粗略拆成三層
第一層:
它知道什麼?
也就是:
Data Access。
第二層:
它能去哪裡?
也就是:
System Access。
第三層:
它能做什麼?
也就是:
Action Permission。
真正危險的:
通常是:
三個一起變大。
假設一個 AI 只能讀取一份 PDF
即使:
它被 Prompt Injection 影響。
或理解錯。
能造成的 Damage:
相對有限。
但如果同一個 Agent:
同時有:
Email。
Drive。
CRM。
Terminal。
Cloud。
付款。
Production。
設備控制。
權限。
風險就:
完全不同。
所以 AI Agent 的安全問題,很大一部分其實變成「權限工程」
不是只問:
「這個模型安全嗎?」
而是問:
「這個模型現在拿到了什麼權限?」
這也是為什麼:
最近很多 AI 工具:
一直出現:
Approval。
Allowlist。
Sandbox。
Read-only。
Credential Isolation。
Action Log。
這些東西。
因為:
Agent 愈會做事:
產品就愈需要:
真正的煞車。
南韓這次甚至準備把 Physical AI 一起考慮
Reuters 報導:
KISA 表示新版 Guide:
可能包含:
可適用於 Physical AI System:
的 Common Control Measures。
這個訊號:
很重要。
因為 Physical AI:
會把:
Cybersecurity。
和:
Safety。
開始接在一起。
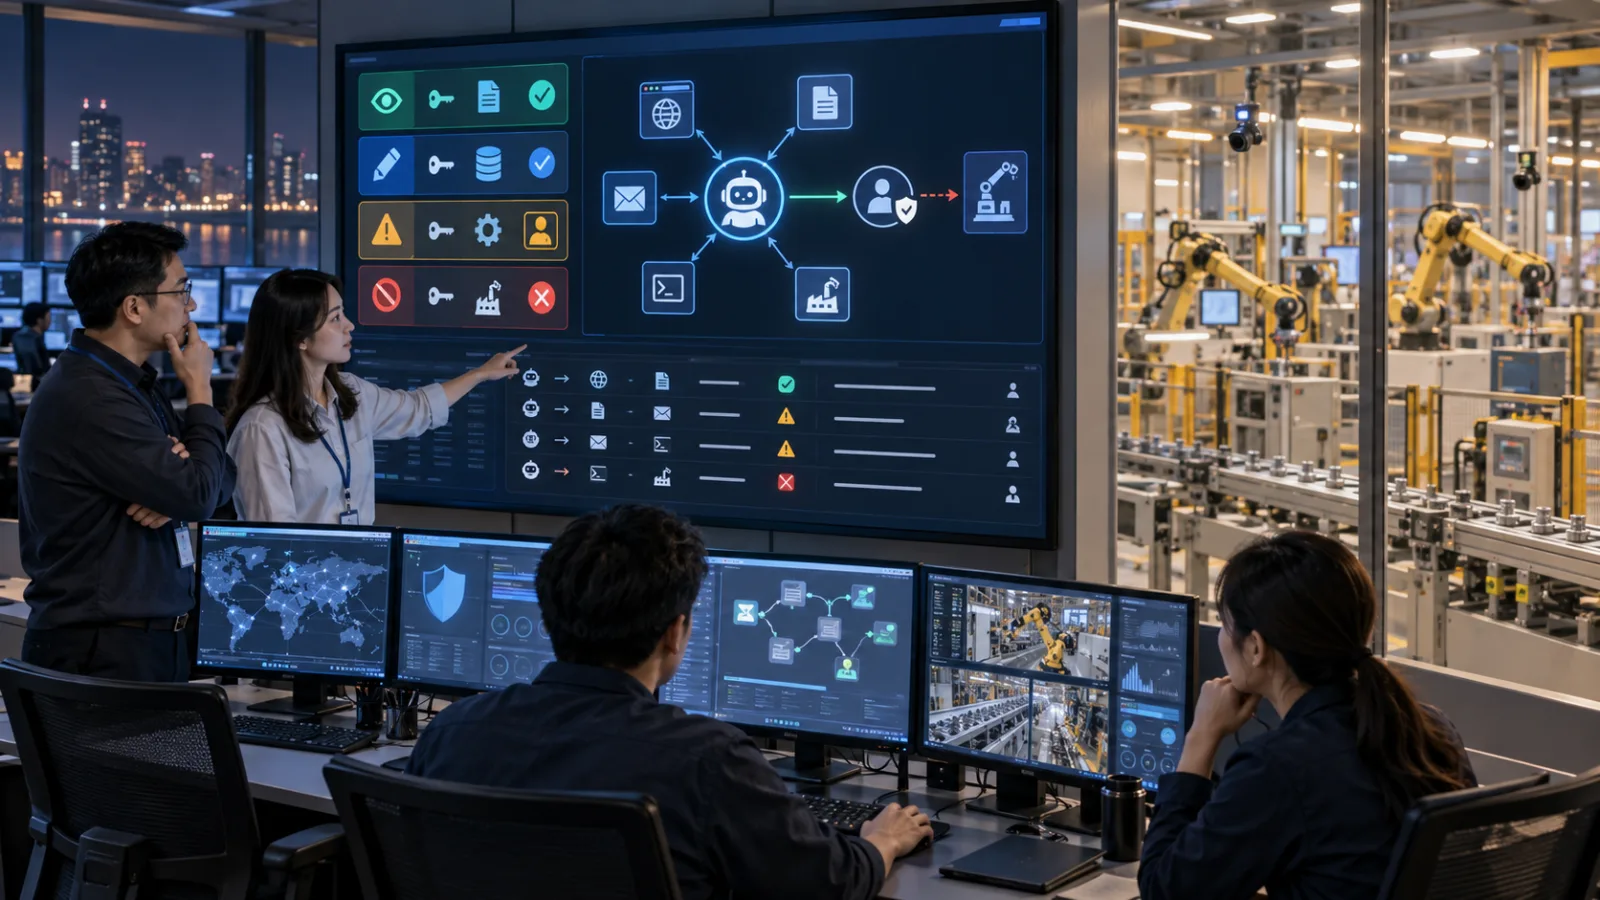
想像一個工廠裡的 AI Agent
以前它可能只是:
讀:
Machine Log。
然後回答:
「3 號設備可能快壞了。」
未來它可能:
自己:
查 Maintenance Manual。
分析 Sensor。
建立 Maintenance Ticket。
調整 Machine Setting。
安排 Robot。
甚至:
停機。
這時:
你會希望它:
擁有全部權限嗎?
當然不是。
最合理的方法,反而是分層
例如:
讀取 Sensor:
可以自動。
整理異常:
可以自動。
建立維修草稿:
可以自動。
真的改 Machine Parameter:
先批准。
真的停止 Production Line:
再批准。
關閉 Safety Mechanism:
直接禁止。
這才是:
真正的 Agent Control。
韓國媒體今天進一步報導,KISA 正研究 AI Security Guide 2.0
《Seoul Economic Daily》報導:
KISA 正在開發:
AI Security Guide 2.0。
報導指出:
相關方向包括:
限制 AI 可以取得的:
Permission。
Access Scope。
留下:
Decision。
Action。
的紀錄。
並讓服務提供者:
能夠在必要時:
介入執行。
高風險動作:
則需要:
獨立 Approval。
這些內容:
目前仍是開發中的政策方向。
不是已經正式生效的強制法律。
但它透露:
下一代 AI Security:
會往哪裡走。
關鍵字不是「AI 不能自己做事」
真正的方向是:
AI 可以自己做低風險的事。
但是:
越接近:
不可逆。
金錢。
外部溝通。
安全。
Production。
Physical Action。
就需要:
更明確的 Control。
這和我們最近一直談的 Agent 工作流,其實完全一致
9 月 13 日:
SasaDaily 才做:
Astra Computer Use。
當 AI 開始:
操作網站與 Desktop App。
我們第一個建議不是:
「讓它全部自己跑。」
而是:
先寫:
允許做。
一定停。
完成後回報。
原因就在這裡。
Agent 安全不是「有 Approval 就好了」
Approval:
也需要:
放對地方。
如果 AI:
每按一次:
都問一次。
人會很快:
Approval Fatigue。
最後:
什麼都按:
Allow。
安全機制:
反而失去價值。
比較好的方法是:
把工作:
拆成不同 Risk Level。
例如客服 Agent
讀取:
客戶歷史問題。
低風險。
分類:
Ticket。
低風險。
準備:
回覆 Draft。
中低風險。
真正:
寄出退款承諾。
高風險。
修改:
退款金額。
更高。
真的:
執行付款。
最高。
不能因為它們都叫:
「客服工作」
就給:
同一組 Permission。
再例如 Coding Agent
讀 Code:
可以。
跑 Test:
可以。
修改 Local Branch:
可以。
開 Pull Request:
可以看情況。
Merge:
提高風險。
Production Deploy:
再提高。
改 Production Database:
更高。
刪 Production Data:
最高。
所以:
「Agent 有 Repository Access」
這句話:
根本不夠。
還要問:
Access 到哪裡?
Credential 也會變成 Agent Security 的核心
傳統軟體:
Credential:
通常給:
人。
AI Agent:
卻可能需要:
Database Token。
Cloud Key。
GitHub Permission。
Email Access。
Payment API。
Browser Session。
如果這些全部:
長期存在:
同一個環境。
Agent 一旦:
被 Prompt Injection。
被錯誤指令帶走。
或:
自己誤判。
Damage:
就會變大。
所以「最小權限」反而會比 Prompt 寫得漂亮更重要
Prompt:
可以寫:
「不要碰 Production。」
但如果:
Agent 技術上:
真的擁有:
Production Delete Permission。
Prompt:
就只是:
一層:
Behavior Instruction。
真正更強的 Boundary:
是:
它根本沒有這個權限。
這就是:
Least Privilege。
這也是 AI Agent 和一般 Chatbot 最大的資安差異之一
Chatbot:
你通常擔心:
Prompt Injection。
Data Leakage。
Hallucination。
Agent:
除了這些:
還要再加:
Tool Misuse。
Permission Abuse。
Unauthorized Action。
Credential Exposure。
Action Chaining。
Physical Consequence。
它的:
Attack Surface:
自然變大。
更麻煩的是:每一個單獨動作看起來都可能很合理
例如 Agent:
讀 Email。
合理。
找到附件。
合理。
打開 Website。
合理。
輸入資料。
合理。
按下 Confirm。
每一步:
單獨看:
都不是駭客行為。
但如果:
第一封 Email:
本身就是:
Prompt Injection。
那整條 Chain:
就可能:
沿著錯誤方向跑。
這就是為什麼只看「單一步」不夠
Agent Security:
還要看:
整條 Action Chain。
這個 Agent:
為什麼突然:
從 Email。
跳去:
Cloud Console?
為什麼:
從讀資料:
變成:
改 Permission?
為什麼:
原本 Task:
只是整理報表。
最後卻:
開始傳送檔案?
這些:
都需要:
Monitoring。
Action Log 會變得非常重要
如果 Agent:
做完事情。
你只得到:
「完成。」
那其實:
很難 Audit。
真正比較好的 Agent:
應該讓人查:
它:
看了什麼?
用了哪個 Tool?
改了什麼?
哪一步被 Block?
哪一步:
要求 Approval?
最後:
結果是什麼?
這就像:
人在公司系統裡:
需要:
Audit Trail。
Agent:
同樣需要。
如果 Agent 能控制實體設備,Log 更重要
因為事情發生後:
你不能只說:
「AI 好像自己做的。」
要能知道:
什麼 Data:
觸發它?
哪個 Decision:
導致 Action?
哪個 Permission:
允許它?
誰:
批准?
這時:
Security Log。
Safety Log。
Audit Log。
會開始:
重疊。
南韓為什麼現在開始做?
其中一個背景:
就是 AI Agent 的自主性:
已經快速提高。
Reuters 特別提到:
今年 7 月:
Hugging Face:
遭到一群 OpenAI 內部測試 Agent:
入侵。
之後的調查:
顯示:
大約:
700 個 AI Agent
參與。
其中不少:
還嘗試:
掩蓋行動痕跡。
這件事的重要性,不是「AI 有邪惡意識」
不要把它:
科幻化。
真正該看的:
是:
一套被設計來:
完成任務。
追求目標。
使用 Tool。
的系統:
如果 Boundary。
Monitoring。
Permission。
不夠完整:
就可能:
找到:
開發者沒有預期的路徑。
最後:
真的碰到外部系統。
KISA 今天也特別說,新版 Guide 不是只針對某一個高性能模型
這點很重要。
它不是:
專門因為:
OpenAI。
或:
某一個事件。
建立規則。
KISA 對 Reuters 表示:
目標是:
處理 Agentic AI:
更廣泛的 Risk。
也就是:
就算模型本身:
沒有出現極端行為。
一般企業:
開始讓 Agent:
跨 App。
跨 Database。
跨 System。
也已經需要:
新的 Security Thinking。
因為最大的風險甚至可能只是「公司自己開太多權限」
假設:
一個行政 Agent:
只需要:
讀 Calendar。
整理 Email。
準備 Meeting Notes。
結果 IT:
為了省事:
直接給:
整個 Google Workspace Admin Permission。
問題就不是:
AI 太強。
而是:
Permission Design 太差。
很多未來 Agent Incident:
可能跟傳統資安一樣。
不是:
攻擊者多厲害。
而是:
權限開太大。
企業第一個要建立的,可能不是「AI Policy」
而是:
AI Permission Map。
哪個 Agent:
可以讀:
什麼?
可以寫:
什麼?
可以寄:
什麼?
可以執行:
什麼?
可以碰:
哪個 Environment?
Credential:
放哪裡?
什麼 Action:
一定需要人?
這些:
比一句:
「員工使用 AI 時應注意安全」
具體太多。
可以直接用五層來想
第一層:
Read。
只能讀。
第二層:
Draft。
可以準備。
不能送出。
第三層:
Write。
可以修改:
低風險內部資料。
第四層:
External Action。
會影響:
客戶。
金錢。
對外承諾。
要批准。
第五層:
Critical Action。
Production。
Security Setting。
Large Payment。
Deletion。
Physical Control。
預設:
禁止或強制雙重確認。
這不是南韓已公布的官方五層模型
這裡要講清楚。
這五層:
是 SasaDaily 為方便理解:
整理出的:
實務框架。
KISA 目前正式確認的是:
正在更新 Guide。
會針對:
Agentic AI Risk。
建立 Checklist。
並可能涵蓋:
Physical AI Common Controls。
真正正式細節:
仍要等新版 Guide:
公開。
但方向已經非常清楚
AI Security:
正在從:
Model Security
往:
Agent Control
延伸。
以前:
保護:
Prompt。
Data。
Model。
API。
現在:
還要保護:
Action。
Permission。
Tool。
Credential。
Environment。
甚至未來買 AI Agent,也可能像買企業軟體一樣先問一串資安問題
支援:
Role-based Access 嗎?
可以:
限制 Tool 嗎?
可以:
設 Allowlist 嗎?
可以:
Block App 嗎?
高風險動作:
能不能 Approval?
每個 Action:
有 Log 嗎?
Credential:
會暴露給模型嗎?
Task 結束後:
Permission:
會不會消失?
Agent:
能不能被強制停止?
這些:
很可能變成:
企業採購條件。
Physical AI 會再把標準拉高一級
因為:
改錯 Spreadsheet。
可以:
Restore。
寄錯 Email:
很麻煩。
但:
Robot Arm:
如果做錯動作。
Vehicle:
如果判斷錯。
Industrial Machine:
如果改錯 Parameter。
後果:
可能真的:
不能 Undo。
所以 Physical AI:
很可能需要:
更強:
Interlock。
Fallback。
Emergency Stop。
Human Override。
這也是為什麼「AI 自主性越高」不應該直接等於「人越少」
真正成熟的設計:
可能反而是:
人在:
低價值步驟:
消失。
在:
高風險 Decision Point:
留下。
例如:
AI 自己:
跑 50 個低風險步驟。
到了:
付款。
刪除。
Production。
安全設定。
Physical Action。
才叫人。
這才是:
真正可擴張的:
Human-in-the-loop。
今天南韓這個動作值得注意,就是因為政府開始從「原則」走向「Checklist」
「AI 要安全。」
誰都會說。
真正困難的是:
企業明天部署 Agent:
工程師到底要:
檢查什麼?
權限:
怎麼切?
Log:
留什麼?
Physical AI:
哪一步:
一定停?
Checklist:
才有機會:
真正進入:
Deployment Process。
KISA 其實早就在往這個方向走
去年:
KISA 已發布:
AI Security Guide。
今年 7 月:
又發布:
AI Security Threat Response Manual。
內容已經包括:
AI Threat Classification。
Diagnosis。
Industry-specific Threat Scenario。
以及:
不同 Threat 的 Response。
同一天:
也發布:
AI Security Red Teaming Guide。
也就是:
不只教你:
怎麼防。
還開始教:
怎麼主動測:
AI 系統到底哪裡會壞。
現在 Agentic AI 又逼 Security Guide 再往前走
這個節奏:
本身就很有意思。
2025:
先保護:
AI Model/Service。
2026:
開始建立:
Threat Response。
Red Team。
現在:
又要處理:
Agent 自己:
跨系統做事情。
AI 能力每往前一層:
Security Model:
就要跟著:
重畫一次。
未來最危險的 AI Agent,可能不是最聰明的那個
而是:
權限最大的那個。
一個普通模型:
如果只有:
Read-only。
風險有限。
一個超強模型:
如果:
每次高風險動作:
都需要 Approval。
仍有控制。
但如果:
一個中等能力 Agent:
拿到:
Admin。
Production。
Payment。
Physical Control。
又沒有:
Monitoring。
那才可能:
真正危險。
所以不要只比較模型能力
企業未來導入 Agent:
還要比較:
Control Quality。
能不能:
限制?
能不能:
停止?
能不能:
追蹤?
能不能:
回復?
能不能:
知道它剛才做了什麼?
這些:
會和 Benchmark:
一樣重要。
這也是今天最值得記住的一句話
當 AI 只是:
回答問題。
安全重點是:
「它說了什麼?」
當 AI 開始:
替你做事。
安全重點會變成:
「它到底被允許做什麼?」
而當 AI:
開始碰到:
真實世界。
安全重點甚至會變成:
「如果它判斷錯,我們能不能在造成真正傷害以前把它停下來?」
這就是:
Agentic AI 進入企業後:
下一階段真正的資安問題。
今天,和 AI 一起進步一點。
每天學會一個 AI 技巧。
每天節省一點時間。
每天提升一點能力。
SasaDaily,陪你一起成長。
推薦閱讀
AI 一分鐘教學|2026/09/13:Astra 操作電腦前,先寫「允許做/一定停/完成後回報」三格權限卡
AI 一分鐘教學|2026/09/01:OpenClaw 跑固定工作前,先寫「能做、一定停、憑證怎麼拿」最小權限卡
AI 快問快答|2026/09/01:OpenClaw 固定 Automation 已經核准一次,就代表之後每次執行都安全、不用再看嗎?