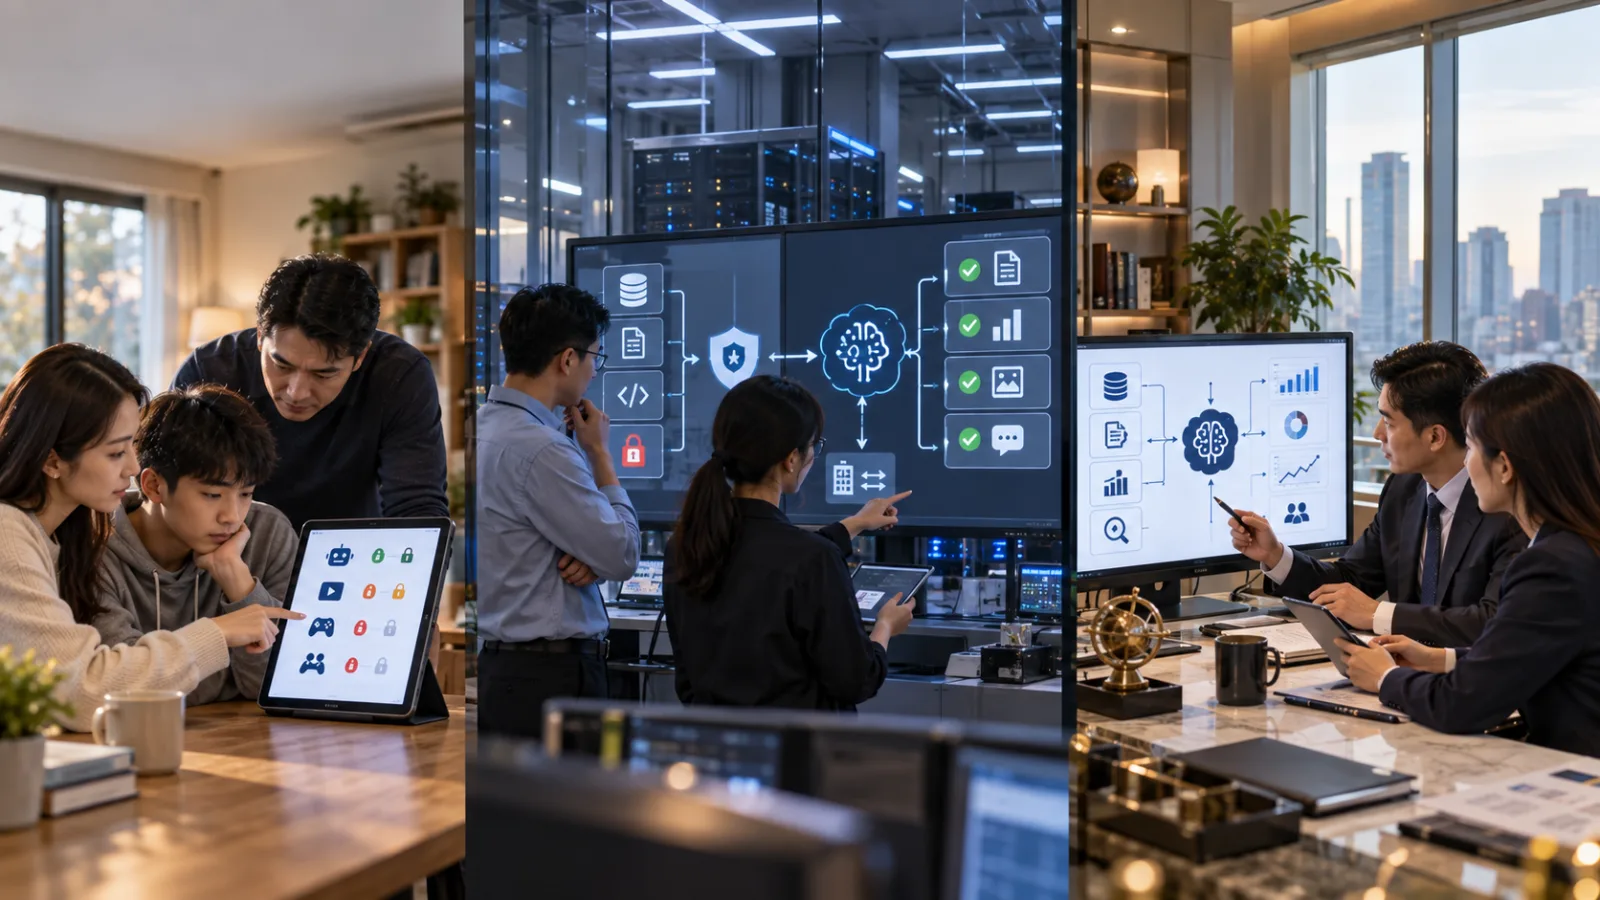
今天三则 AI 新闻:
一则在问:
孩子几岁以前,不应该自己打开 AI Chatbot?
一则在问:
公司的机密数据,到底敢不敢交给最强模型?
第三则则是:
金融顾问如果真的要把 AI 放进客户服务,应该直接接哪些专业系统?
看起来是:
儿童保护。
企业资安。
金融工具。
三个完全不同的题目。
但它们其实都在回答:
同一件事。
AI 进入真正生活与工作后:
问题已经不只是:
「模型能不能做?」
而是:
「谁可以用?」
「可以看到什么?」
「在哪个范围里用?」
AI 正从:
全民共用的一个聊天框。
开始变成:
分级访问的基础设施。
第一则:欧盟准备把 AI Chatbot 放进 15 岁以下限制范围
Reuters 9 月 14 日看到一份:
European Commission 文档。
欧盟正准备提出:
EU Kids Act。
如果按照目前草案方向:
15 岁以下儿童:
原则上将不能自己直接创建帐号使用:
Social Media。
Video-sharing Platform。
AI Chatbot。
Online Game。
这可能成为目前全球最广泛的:
儿童数字服务年龄限制之一。
这次不只是管 Instagram、TikTok
这点非常重要。
过去谈:
儿童网络保护。
第一个想到的通常是:
Social Media。
因为:
成瘾。
短影音。
陌生人接触。
Cyberbullying。
有害内容。
但这次 Reuters 看到的草案:
直接把:
AI Chatbot
一起放进来。
这代表政策制定者开始把:
ChatGPT 类服务。
不只是看成:
搜索工具。
学习工具。
或 Productivity Tool。
而是:
一种会长时间和儿童交互的:
数字服务。
为什么 AI Chatbot 会被一起管?
因为 AI 的交互方式:
和传统网站不同。
搜索引擎:
你问一题。
得到结果。
AI Chatbot:
却可以:
一直对话。
记住 Conversation Context。
给建议。
安慰。
角色扮演。
甚至形成:
很像真人陪伴的交互。
对成年人来说:
这可能只是:
方便。
对未成年人:
政策制定者会开始问:
什么年龄以前,需要更多家长控制?
草案不是简单的「15 岁以下全部断网」
Reuters 报导的架构:
其实比较像:
Gradual Access。
15 岁以上:
可以自己创建帐号。
13~14 岁:
可以由家长替孩子创建:
Introductory Account。
并搭配:
Parental Control。
有限联系。
严格使用时间。
3~12 岁:
帐号由家长完全控制。
而且只能进入:
符合儿童安全标准的服务。
3 岁以下:
则不开放这类服务。
这代表「年龄验证」会变成非常大的技术问题
如果平台不能只相信:
用户自己填:
「我 18 岁。」
那要怎么知道:
真正年龄?
身分证?
信用卡?
脸部 Age Estimation?
政府 Digital Identity?
家长帐号?
每一种方案:
都会碰到:
Privacy。
Data Minimisation。
身份追踪。
儿童数据。
新的问题。
所以:
保护儿童
和:
不要创建大型年龄监控系统
之间:
本身还有很大的政策拉扯。
欧盟已经在替未成年人在线安全铺路
European Commission 先前公布的:
DSA 未成年人保护指南。
已经要求平台:
考虑降低:
Addictive Design。
无限推荐。
自动播放。
通知轰炸。
以及:
对平台内 AI Chatbot:
增加 Safeguard。
现在如果 EU Kids Act:
真的往年龄门槛再走一步:
代表治理方式:
开始从:
「孩子可以用,但平台要更安全」
进一步变成:
「某些服务在特定年龄以前,根本不应该直接自由进入」。
但这还不是已经生效的法律
这点一定要说清楚。
Reuters 报导的是:
Commission 文档中的提案方向。
European Commission:
仍需正式提出方案。
接着:
还要和:
EU Member States。
European Parliament。
协商。
整个过程:
可能需要很多个月。
细节:
也可能改变。
所以现在不能写成:
「欧盟已正式禁止 15 岁以下使用 ChatGPT。」
还没有。
比较准确的是:
欧盟准备提出一套可能涵盖 AI Chatbot 的 15 岁以下数字服务限制。
第二则:最懂 AI 的公司,反而开始限制自己使用外部 AI
今天第二则:
很值得企业注意。
Reuters 引述:
The Information 报导:
Palantir。
Nvidia。
Booz Allen Hamilton。
等公司:
正在重新评估:
外部 Advanced AI Model:
到底可以用到什么程度。
原因不是:
模型不好用。
反而是:
模型太好用。
大家开始想把:
Source Code。
Cybersecurity Work。
Proprietary Data。
Research。
放进去。
问题就出现了。
Palantir 据报直接要求不可撤销的 Zero Data Retention 保证
Reuters 引述知情人士称:
Palantir 希望 Anthropic:
先提供:
irrevocable zero-data-retention guarantees
才愿意:
让相关模型更广泛地透过 Palantir Software 使用。
这个要求:
其实非常强。
不是:
「我们相信你不拿来训练。」
而是:
这些数据到底能不能留下来?
Nvidia 据报则采取另一种方式
Reuters 报导:
Nvidia:
把 Anthropic 模型:
限制在:
相对不敏感的工作。
更敏感的内部用途:
则会使用:
自己控制的:
Nemotron Model。
这是一个非常有意思的信号。
因为 Nvidia:
根本不是不相信 AI。
它自己就是:
AI Boom 最大受益者之一。
真正的问题是:
模型能力强不强
和:
公司愿不愿意把最内核数据交给它
是两回事。
Booz Allen 据报甚至禁止部分专有资安工作使用 Anthropic 商业模型
Reuters 引述报导称:
Booz Allen:
已限制员工:
不能把 Anthropic 商业模型:
用在某些:
Proprietary Cybersecurity Work。
理由也很好理解。
Cybersecurity Data:
可能包含:
漏洞。
客户架构。
攻击方式。
内部防护。
Access Information。
这些数据:
如果治理方式不够清楚:
风险可能比:
少用一点 AI。
大得多。
这里最容易被误解成:「Anthropic 会拿企业数据训练 Claude」
不能这样直接写。
Reuters 同时指出:
Anthropic 与 OpenAI 都表示:
企业客户数据:
预设不会拿去训练模型。
除非客户:
主动 Opt in。
但企业现在担心的:
不只:
Training。
还有:
Retention。
Logs。
Metadata。
Security Review。
以及数据到底:
在系统里存在多久。
Anthropic 据报曾因 30 天 Usage Log Retention 引起客户反弹
Reuters 引述 The Information 称:
Anthropic 在今年 6 月:
修改部分 Fable 使用政策。
为了防范:
Complex and Novel Attacks。
可保留:
部分 Usage Logs:
最多 30 天。
这项变化:
据报引发部分企业客户反弹。
原因就是:
对一般用户:
30 天也许没什么。
对:
国防。
芯片。
Cybersecurity。
Finance。
等企业:
30 天:
可能是一个非常大的 Governance Question。
这会让「Zero Data Retention」变成企业 AI 的产品功能
以前选 AI:
大家比较:
Benchmark。
Token Price。
Context Window。
Latency。
现在大型企业可能开始把:
Retention Policy
放到:
同样重要的位置。
例如:
这次 Prompt:
保存多久?
Output:
保存多久?
Log:
保存多久?
谁能查看?
谁能 Audit?
Incident 发生时:
数据会不会被保留?
这些:
很快会直接影响:
企业采购 AI 的决策。
甚至「用自己的模型」可能重新变得有价值
过去企业可能会想:
既然 OpenAI。
Anthropic。
Google。
的 Frontier Model:
能力最好。
为什么还要:
自己养模型?
原因之一:
就是:
Control。
能力可能:
不是世界第一。
但模型放:
自己的环境。
数据不出去。
Retention:
自己定。
Audit:
自己做。
对:
最敏感工作。
反而可能:
更值得。
所以未来企业 AI:
很可能不是:
一家公司只选一个模型。
而是:
普通工作:
用外部 Frontier Model。
敏感工作:
进隔离环境。
最高敏感:
用内部 Model。
形成:
Model Routing by Risk。
第三则:Anthropic 推 Claude for Financial Advisors
同一天:
Anthropic 又往完全相反方向:
把 Claude:
更深地推进:
金融业。
Anthropic 9 月 14 日推出:
Claude for Financial Advisors。
这次不是:
做一个:
「金融版 Chatbot Skin」。
而是:
直接连接:
财富管理与投资分析工具。
Reuters 点名的合作系统包括:
BlackRock。
Charles Schwab。
Addepar。
另外还有:
Envestnet。
iCapital。
Orion。
Wealthbox。
Wealth.com。
Zocks。
主要工作是什么?
不是:
「帮客户自动买股票。」
Reuters 报导的用途:
比较接近:
Client Meeting Preparation。
Portfolio Review。
Follow-up Work。
也就是:
金融顾问真正每天在做:
但非常花时间的:
知识工作。
例如开客户会议前
顾问可能要:
回顾:
Portfolio。
最近交易。
Asset Allocation。
客户先前要求。
市场变化。
研究数据。
再整理:
今天要问什么。
如果 Claude:
可以从:
正式 Wealth-management System。
Investment Analytics。
中取得授权数据:
它就不需要:
只靠一般网络知识:
猜。
这和一般人问 Claude:「我应该买什么股票?」完全不是同一件事
一般 Chatbot:
拿到的:
可能是:
公开市场数据。
一般财务知识。
用户提供的信息。
Claude for Financial Advisors:
则开始往:
Institutional Workflow
走。
它要接:
公司已经在用的:
Portfolio。
Wealth-management。
Client。
Analytics。
系统。
所以价值不只是:
回答能力。
而是:
Context。
这也接在 OpenAI 几天前的动作后面
9 月 11 日:
SasaDaily 才整理:
OpenAI 推出:
ChatGPT for Financial Services。
锁定:
Investment Banker。
Equity Research。
Financial Modeling。
Client Material。
现在:
Anthropic 又把:
Financial Advisor。
Wealth Management。
往下切。
AI 公司很明显正在:
从:
「一个模型服务所有人」
走向:
一个产业一套 Workflow。
为什么金融业变成前沿 AI 必争之地?
第一:
信息量非常大。
第二:
Research。
Analysis。
Document。
Meeting Preparation。
都有大量重复工作。
第三:
这些工作:
本来就非常高成本。
如果 AI 能把:
两小时整理:
压成:
20 分钟 Review。
商业价值很高。
但同时:
金融业又有:
非常高的:
数据敏感度。
监管。
合规。
责任。
这就让今天三则新闻:
刚好连在一起。
Claude for Financial Advisors 愈深入,就愈需要前一则的数据治理
想像一下:
AI 可以读:
客户资产。
Portfolio。
投资产品。
Financial Plan。
会议纪录。
如果数据保留:
权限。
Audit。
第三方模型使用。
没有讲清楚:
那么:
功能越强。
企业反而:
越不敢用。
所以金融 AI:
真正的竞争:
最后不一定只是:
哪个模型:
回答更准。
还可能是:
哪家公司能让 Compliance Team 放心签字。
这可能是接下来企业 AI 最重要的分水岭
第一阶段:
大家问:
AI 能不能用?
第二阶段:
大家问:
哪个 AI 最强?
现在第三阶段:
开始变成:
哪种人,可以把哪种数据,交给哪个 AI,做哪种工作?
未成年人:
需要 Age Gate。
一般企业:
需要 Data Policy。
金融:
需要 Industry Workflow。
医疗:
需要 Medical Data Controls。
政府:
需要 Security Boundary。
不是所有人:
都拿到:
完全一样的 Chatbot。
这和智能型手机发展其实很像
早期 Internet:
你只需要:
Browser。
后来不同领域:
开始长出:
Banking App。
Kids Mode。
Enterprise Device Management。
Healthcare System。
Government Identity。
真正成熟的技术:
最后一定会:
分化。
AI:
现在也开始:
走到这一步。
「最好用的 AI」未来甚至可能因人而异
对学生:
最重要的可能是:
Age Appropriate。
Privacy。
Learning Safeguard。
对工程师:
可能是:
Coding Capability。
Context。
Repository Access。
对企业:
可能变成:
Zero Retention。
Audit。
Permissions。
对 Financial Advisor:
则是:
Portfolio Context。
Approved Data。
Compliance。
所以 AI 产品:
不会只剩:
一张:
Benchmark Ranking。
AI 的商业化,反而正在增加更多限制
这听起来很矛盾。
一般想像:
科技进步:
就是:
更多人。
用更多功能。
但 AI 真正进入:
儿童。
银行。
政府。
企业内部。
之后:
成熟的标志反而可能是:
限制变多。
谁可以进?
什么数据可以看?
可以保留多久?
能不能采取 Action?
哪一步需要 Human Approval?
这些都会:
变成产品的一部分。
所以今天最值得记住的,不是哪一家又推出新 AI
而是:
AI 开始从:
Capability Layer
走进:
Access Layer。
能力层回答:
模型会什么?
Access Layer 回答:
谁能使用这些能力?
在什么条件下?
拿什么数据?
到什么程度?
如果这层没有做好:
能力愈强:
风险可能反而:
愈大。
这三则新闻刚好画出三条未来界线
第一条:
Age Boundary。
孩子几岁以前:
不能完全自由使用?
第二条:
Data Boundary。
什么企业数据:
不能直接交给外部模型?
第三条:
Professional Boundary。
真正进入金融等专业产业时:
AI 到底应该接哪些正式工具?
又在哪里:
停在人类专业判断之前?
所以 AI 下一阶段不是「让所有人得到同一个超级助手」
更可能变成:
不同的人:
拿到:
不同权限。
不同数据。
不同工具。
不同 Approval。
这听起来:
没有:
「一个 AI 什么都做」
那么科幻。
但它反而:
更接近:
AI 真正进入社会的样子。
当 AI 能力愈来愈强:
真正决定它能不能大规模使用的:
可能不是:
下一个 Benchmark。
而是:
我们能不能很清楚地回答——这个人,在这个情境里,到底应该被允许让 AI 做到哪里。
今天,和 AI 一起进步一点。
每天学会一个 AI 技巧。
每天节省一点时间。
每天提升一点能力。
SasaDaily,陪你一起成长。
推荐阅读
AI 今日早报|2026/09/11:ChatGPT 推金融业专版、Visa/Mastercard/Ant 替 AI Agent 建身份规则、IBM+NASA 开源月球 AI
AI 快问快答|2026/08/29:Claude for Teachers 不拿对话训练模型,就代表任何学生数据都可以放心丢进去吗?