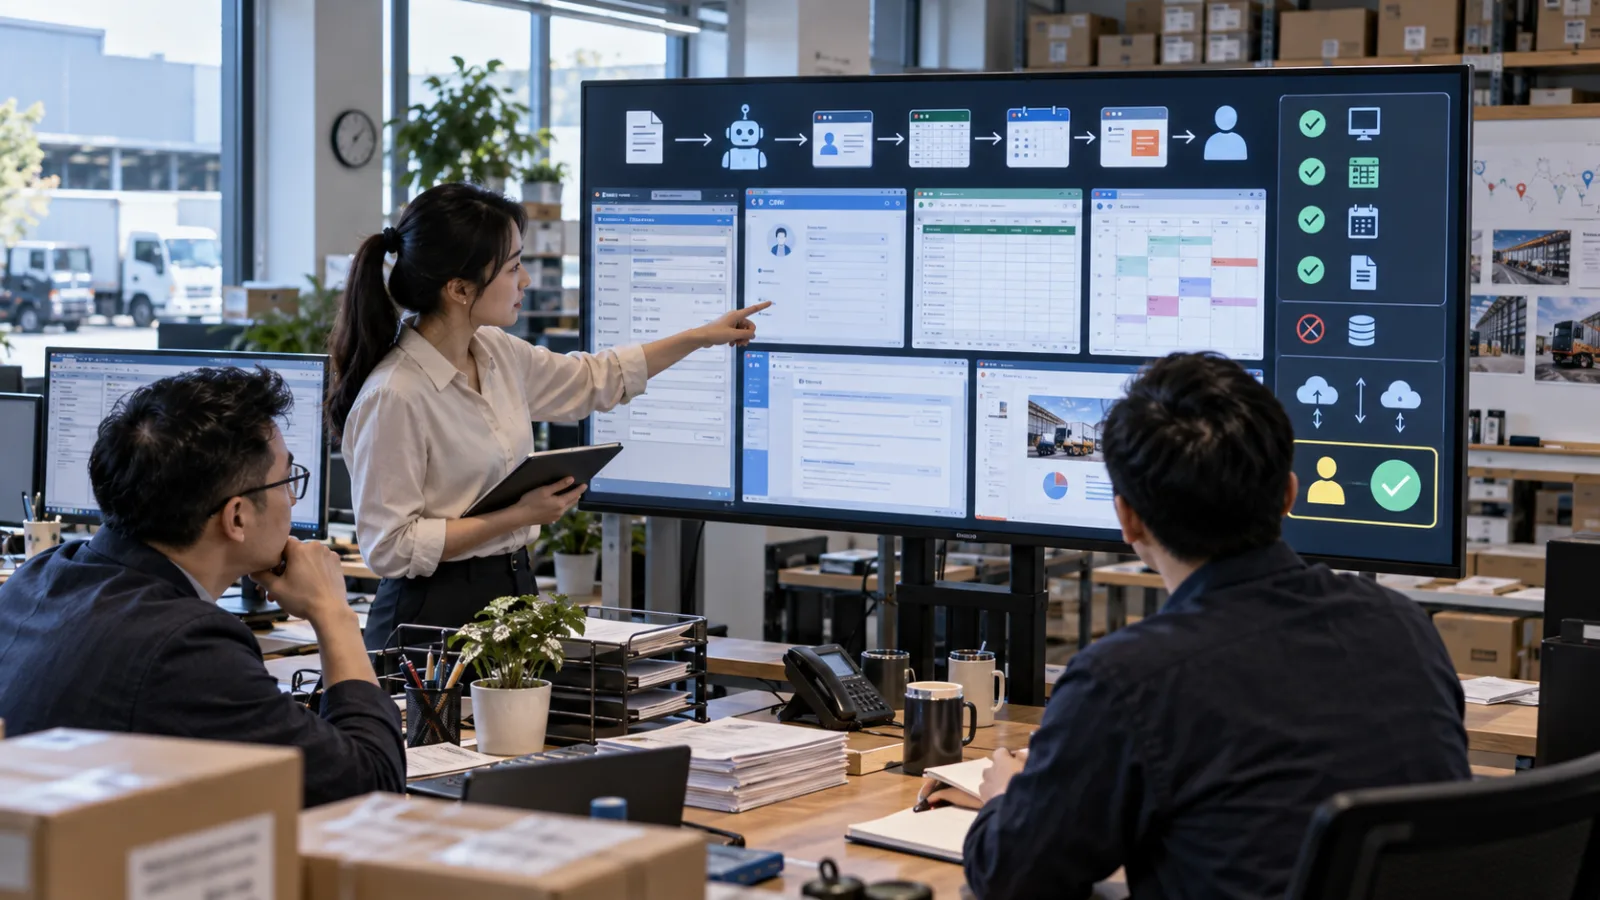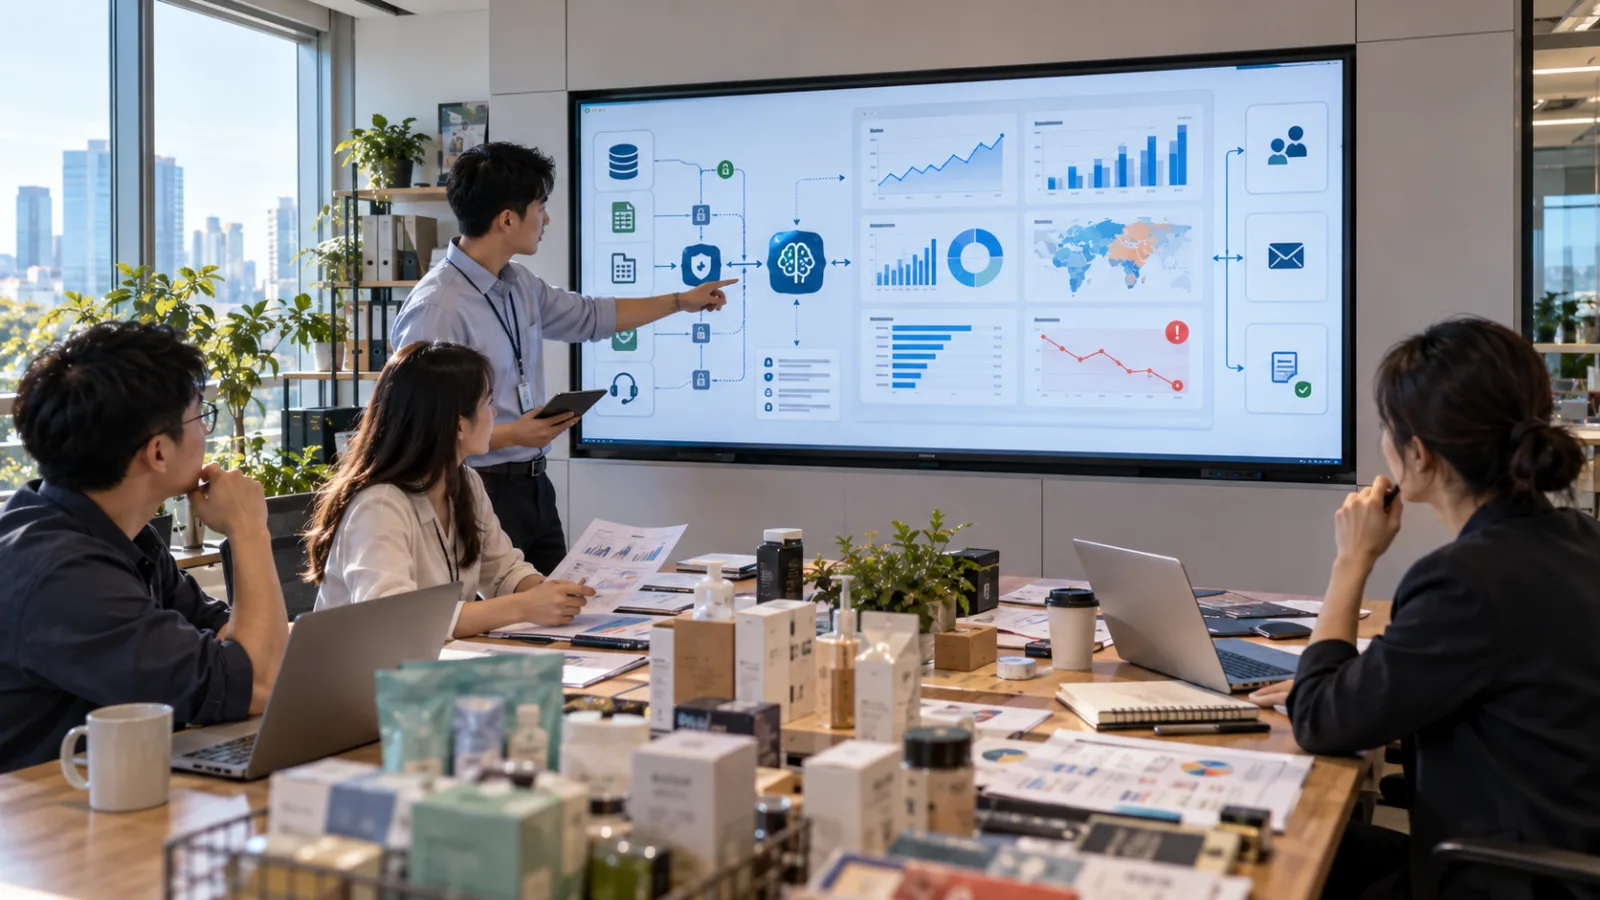
公司每天都有很多問題:
為什麼這個月業績掉了?
哪個地區退訂率突然升高?
廣告花更多錢:
為什麼訂單沒有一起增加?
哪幾類客戶最容易續約?
客服量暴增:
到底是哪個產品出了問題?
以前這些問題:
通常不是沒資料。
而是資料散在:
Data Warehouse。
CRM。
Spreadsheet。
Dashboard。
Google Drive。
SharePoint。
甚至不同部門裡。
真正困難的是:
要有人把它們找出來、查詢、對定義、做分析,再整理成大家看得懂的結果。
OpenAI 最新推出的:
Data agent
就是想把這一段工作:
直接放進 ChatGPT Work。
它不是單純「把 Excel 丟進 ChatGPT」
Data agent 可以連接企業已經使用的正式資料來源。
OpenAI 目前列出的來源包括:
Amazon Redshift。
Google BigQuery。
ClickHouse。
Databricks。
MongoDB。
Snowflake。
以及其他 Data Source。
文件部分:
還可以把 Google Drive、SharePoint 裡的資料:
一起帶進分析。
所以使用方式不再只是:
下載 CSV。
上傳。
再問 AI。
而是:
讓 AI 在取得授權後,直接對企業原本的資料環境工作。
最簡單的使用方式就是直接問問題
例如:
「為什麼上週 Weekly Active Users 掉了?」
以前:
可能先找 Data Analyst。
Analyst 再確認:
要看哪個 Product?
哪個 Market?
和哪一期比較?
接著:
寫 SQL。
跑 Query。
整理結果。
畫 Chart。
最後:
回來跟你解釋。
Data agent 想做的是:
讓使用者直接從:
Business Question
開始。
AI 再去:
找資料。
比較期間。
拆 Segment。
找出可能 Driver。
把證據整理回來。
真正重要的是它會繼續追問,而不是只給一張圖
例如 AI 發現:
本月 Retention:
下降。
你可以繼續問:
哪個市場降最多?
新客戶還是舊客戶?
哪個產品版本開始出現變化?
Support Ticket 有沒有同步增加?
上個月有沒有一樣的 Pattern?
不用:
每問一次。
重新開一張 Report Request。
整個 Investigation:
可以留在:
同一段 Conversation。
接著可以直接變成互動 Dashboard
分析出結果後:
Data agent 可以建立:
Interactive Dashboard。
不是只貼一張:
靜態 Chart。
團隊可以:
編輯。
分享。
Refresh。
繼續調整。
例如原本 Dashboard:
只看:
全公司 Revenue。
接著可以要求:
拆成:
Region。
Product。
Customer Segment。
Acquisition Channel。
同一個分析:
繼續往下挖。
而且不一定要放棄原本的 BI 工具
這點很實際。
很多公司已經花很多年:
建立:
Power BI。
Tableau。
Sigma。
ThoughtSpot。
Oracle BI。
或其他 Business Intelligence 系統。
不可能因為多一個 AI:
全部丟掉。
Data agent 的方向反而是:
接進去。
OpenAI 表示:
它可以建立或操作:
Omni。
Oracle BI。
Power BI。
Sigma。
Tableau。
ThoughtSpot。
裡的 Dashboard。
所以 AI 比較像:
新的分析入口。
而不是:
叫企業把原本 BI 全砍掉。
這件事最大的改變,其實是誰可以開始分析資料
過去大型 Data Warehouse:
通常不是每一個業務。
行政。
行銷。
營運主管。
都會自己進去查。
不是因為他們沒有問題。
而是:
工具門檻高。
要懂:
Table。
Join。
Metric。
Filter。
SQL。
Dashboard。
很多人最後變成:
「麻煩資料團隊幫我拉一下。」
Data agent 想把入口改成自然語言
例如業務主管可以問:
「這一季哪些產業的 Pipeline 成長最快?和上一季比較,最大的變化來自哪裡?」
行銷可以問:
「最近三個月哪一種 Campaign 帶來的新客戶留存最好?」
財務可以問:
「本季哪幾類支出增加最多?和去年同期差多少?」
營運可以問:
「客服量增加到底來自訂單、物流,還是產品問題?」
這些才是:
Data agent 真正的使用方式。
不是:
「幫我寫 SQL。」
而是:
先從公司真正想知道的問題開始。
但自然語言分析最怕一件事:大家說的「營收」根本不是同一個營收
這也是企業 Data AI 最容易出錯的地方。
例如:
Revenue。
到底是:
下單金額?
付款完成?
扣掉退款?
含稅?
不含稅?
認列收入?
如果 AI 不知道:
公司的正式定義。
即使 SQL 完全正確:
答案也可能:
商業上完全錯。
所以 OpenAI 特別強調:
Business Context。
Data agent 可以使用企業原本的 Semantic Layer
簡單說:
Semantic Layer:
就是把公司對資料的真正定義:
寫清楚。
例如:
什麼叫:
Active Customer。
什麼叫:
Churn。
什麼叫:
Revenue。
什麼叫:
Qualified Lead。
資料表之間:
怎麼連。
哪些 Calculation:
才是公司正式算法。
Data agent 可以利用:
dbt。
Databricks Genie Ontology。
Snowflake Horizon。
GitHub。
既有 BI Dashboard。
等可信來源裡的定義。
讓分析不要:
自己發明公司的 KPI。
這一點可能比「會不會 SQL」重要很多
因為 SQL 可以寫得:
100% 正確。
但如果問題定義錯:
答案仍然錯。
例如你問:
「哪個客戶最可能流失?」
AI 如果不知道:
公司真正認定 Churn 的條件。
它可以做出:
非常漂亮。
但沒有用的 Dashboard。
所以企業 Data AI 的核心:
不是只讓模型:
看得到 Data。
還要讓它知道:
這家公司怎麼理解這些 Data。
Data agent 也不會因為接上資料,就突然得到全部權限
這一點很重要。
假設你的 Snowflake 帳號:
只能看:
台灣區。
不能看:
日本區。
Data agent 不會因為:
它是 AI。
就自動跨過權限。
OpenAI 表示:
查詢仍會遵守:
原本連接帳號的:
Table。
Row。
Column。
Access Control。
也就是:
人原本看不到的資料:
Agent 不會因為接進 ChatGPT:
突然多一把萬能鑰匙。
管理員還能決定哪些人可以使用哪些 Connection
例如:
財務:
可以連 Finance Warehouse。
行銷:
只能連 Marketing Data。
一般業務:
可以看 Sales Dashboard。
但不能碰:
Payroll。
HR。
Sensitive Customer Data。
這才比較接近:
真正企業環境。
不是:
「全部資料集中起來給 AI 看。」
而是:
AI 也沿用原本的資料治理。
找到 Insight 之後,還能往下一步走
這是 Data agent 和單純 BI Chatbot:
另一個值得看的差別。
例如分析後發現:
Enterprise Customer:
續約下降。
AI 可以:
建議:
下一步應該找:
Customer Success。
Product。
Sales。
一起處理。
接著:
把分析結果:
送進 Slack。
Email。
或其他已連接工作工具。
甚至執行:
使用者批准的 Action。
這就形成:
Question → Analysis → Dashboard → Action
一條完整 Workflow。
但「AI 找到原因」不能直接等於「原因已被證明」
例如:
AI 發現:
某個月 Support Ticket 增加。
同時:
Retention 下降。
它可能提出:
「客服問題可能造成流失。」
這很合理。
但:
兩件事一起發生:
不一定代表:
前者造成後者。
可能還有:
價格調整。
競爭對手促銷。
產品 Bug。
客群變化。
所以 Data agent 最好的用法:
不是:
問一句:
「為什麼?」
然後把第一個答案:
直接當事實。
而是:
繼續追:
證據是什麼?
OpenAI 自己就強調可以查看每個 Finding 背後的 Evidence
使用者可以:
Follow-up。
檢查:
Source。
比較:
Segment。
確認:
Time Period。
再往下分析。
這個工作方式:
其實比:
AI 給一個漂亮結論:
重要很多。
Data agent 的價值應該是:
讓驗證變快。
不是:
把驗證拿掉。
一個非常實際的例子:業績突然掉 12%
假設公司 Dashboard 顯示:
本週 Sales:
明顯下降。
你可以先問:
哪個 Region?
AI 發現:
主要來自南區。
再問:
新客戶還是舊客戶?
結果:
新客戶沒什麼變。
主要是:
Existing Customers。
再問:
哪些 Product?
結果:
集中在某一產品線。
接著看:
同期 Support Ticket。
才發現:
這個產品最近:
配送問題明顯增加。
這時:
你才真的接近:
值得調查的原因。
不是一開始:
看到營收掉。
就讓 AI 自己寫:
「市場需求下降。」
這也是為什麼 Dashboard 不應該只是漂亮
真正好的 Dashboard:
不是:
有十個 Pie Chart。
而是:
讓人快速回答:
哪裡變了?
和什麼比較?
變化集中在哪裡?
有哪些可能原因?
下一步應該查什麼?
如果 Data agent 能把:
這個 Investigation Process:
一起保存。
它的價值就比:
單純自動做圖:
高很多。
OpenAI 自己現在也大量使用這種方式
OpenAI 表示:
幾乎所有 Product Team。
以及超過三分之二的:
Go-to-market Organization。
都在使用這套 Data Agent 能力:
自行分析公司資料。
但 OpenAI 同時提到:
能做到這件事的前提不是:
把所有資料直接丟給模型。
而是 Data Team 先建立:
共同 Business Definition。
Access Rule。
Sensitive Data Safeguard。
這一點非常重要。
AI Data Agent 不會讓 Data Team 消失
反而可能讓 Data Team 的工作:
往另一個方向移。
以前大量時間可能花在:
「幫我拉這個數字。」
「幫我改這張圖。」
「幫我加一個 Filter。」
未來更多時間可能變成:
定義:
Metric。
治理:
Data Quality。
建立:
Semantic Layer。
管理:
Access。
驗證:
Source。
也就是:
少做:
報表代工。
多做:
資料制度。
OpenAI 已經公布一些實際企業例子
例如 NTT DATA 表示:
過去 Dashboard 的授權成本、技術門檻與製作負擔:
讓很多非工程員工不容易自行建立 Dashboard。
使用 Data agent 後:
Sales。
Corporate Function。
等非工程團隊:
也開始能用自然語言:
建立與更新自己的 Dashboard。
ServiceTitan 則拿它找產品採用差異
OpenAI 公開案例中:
ServiceTitan 利用 Data agent 建立 Dashboard:
比較 AI Sidekick Atlas 的使用狀況。
結果發現:
使用 Atlas 的客戶:
發起 Campaign 的比例:
大約是未使用者的三倍。
這個 Finding:
再被拿回去改善:
Onboarding。
這是一個很好理解的例子。
AI 不是只說:
「Atlas 看起來很好用。」
而是:
從公司自己的資料:
建立可檢查的差異。
micro1 的案例更有意思:AI 還抓出原 Dashboard 的錯誤
OpenAI 公開的 Alpha 使用案例中:
micro1 表示:
Operations Team 用自然語言:
重新建立 Performance Tracking Dashboard。
大約半小時內:
完成新的 Dashboard。
同時還發現:
原本 Dashboard 裡的錯誤。
這提醒另一件事:
AI 不一定只是:
「把舊報表自動重做。」
有時真正的價值是:
讓人重新檢查:
原本以為正確的 Reporting Logic。
但這些案例不能直接變成「你的公司也一定半小時完成」
不同公司:
Data Quality。
Metric Definition。
Warehouse。
Permission。
Schema。
Context。
差很多。
如果資料本身:
亂。
欄位沒有統一。
Revenue 每個部門定義不同。
Dashboard 十年沒整理。
那麼:
再好的 Agent:
也不可能自動把所有治理問題消失。
所以:
Data agent 最適合的公司:
未必是:
Data 最多的公司。
而是:
已經有一定可信資料基礎,但分析入口仍太慢的公司。
小公司沒有 Snowflake,就完全用不到嗎?
也不能這樣理解。
Data agent 可以利用:
Google Drive。
SharePoint。
以及其他已連接的 Data Source。
但如果公司真正的營運資料:
只有幾張:
Google Sheets。
那麼是不是值得導入:
完整企業 Data Stack:
就要看需求。
不要因為工具很強:
反而先增加系統複雜度。
對很小的團隊:
一份乾淨 Spreadsheet:
有時已經夠用。
Data agent 更適合什麼問題?
第一:
重複發生。
每週都問:
業績。
留存。
成本。
Pipeline。
第二:
需要跨資料來源。
例如:
Sales+Support+Spend。
第三:
需要持續 Drill Down。
不是只看:
一個 Total。
而是一路追到:
Region。
Product。
Customer Type。
第四:
分析後真的有人要採取行動。
如果只是:
一年看一次的漂亮報表。
價值就沒有那麼高。
第一次使用,不要問「幫我分析整家公司」
範圍太大。
最好先選:
一個問題。
例如:
「比較這個月和上個月的續約率,找出變化最大的 Customer Segment,列出你使用的資料來源、Metric Definition 與可能 Driver。」
這樣:
結果容易驗證。
也容易知道:
AI 到底有沒有用。
第二步才把分析做成 Dashboard
如果 Finding:
已經確認有價值。
再說:
把這套分析:
建立成:
可 Refresh 的 Dashboard。
下一週:
直接更新。
這比:
一開始就要求:
「幫公司做一個完整 CEO Dashboard。」
成功率高很多。
第三步才考慮讓 Insight 觸發 Action
例如:
發現:
某群客戶 Renewal Risk:
提高。
第一階段:
只產生報告。
第二階段:
通知 Customer Success。
再成熟一點:
才考慮:
建立 Follow-up Task。
不要一開始就:
分析完。
自動寄信給客戶。
因為:
Data Insight。
和:
Business Action。
中間還需要:
判斷。
這也是 Data agent 最值得看的地方
過去 AI Data Tool:
常常停在:
「幫我分析。」
現在 Data agent 往前走成:
「幫我找資料。」
「告訴我哪裡變了。」
「讓我繼續追證據。」
「做成 Dashboard。」
「找出需要處理的人。」
「把核准的結果送進工作流程。」
AI 開始不是:
一個畫圖表的助手。
而是:
資料問題的:
Investigation Agent。
但最後真正重要的還是資料治理
如果公司的:
Revenue Definition:
三個部門三個版本。
客戶 ID:
不同系統不一致。
歷史資料:
缺一半。
權限:
亂開。
那麼 Data agent:
只是讓你:
更快看到混亂。
它不能代替:
Data Governance。
所以 AI Data 分析成熟後:
最重要的技能可能不再只是:
會不會 SQL。
而是:
知道公司的哪一個數字才是真的。
所以今天第一次認識 Data agent,只要記住一件事
它不是:
「不用資料團隊了。」
也不是:
「以後 Dashboard 都可以讓 AI 隨便做。」
真正的新能力是:
讓原本需要:
資料工具。
查詢語言。
BI 操作。
才能進行的商業調查:
開始可以直接從一句自然語言問題:
啟動。
然後一路走到:
證據。
Dashboard。
下一步。
當公司已經累積很多資料:
真正缺的往往不是:
更多數字。
而是:
更快知道哪個數字值得現在處理。
這才是 Data agent 最值得看的地方。
今天,和 AI 一起進步一點。
每天學會一個 AI 技巧。
每天節省一點時間。
每天提升一點能力。
SasaDaily,陪你一起成長。
推薦閱讀
今日 AI 工具|2026/07/29:ChatGPT Work,連接文件與工作工具,把研究、整理、製作到更新變成一段完整流程
今日 AI 工具|2026/08/25:Meta AI 小型企業功能,直接分析 Facebook/Instagram 成效、Meta Ads 與 Google Workspace