如果你每周都有:
会议录音、
客户访谈、
课程录音、
Podcast 访谈、
语音笔记,
真正麻烦的通常不是:
「我没有录到。」
而是录完之后,
还要把声音变成:
逐字稿、
摘要、
待办、
决定事项,
最后才能真的拿来工作。
ChatGPT 现在正式多了一个很直接的做法:
把 Audio File 直接上传。
它和 ChatGPT Voice 有什么不同?
ChatGPT Voice 是:
你现在直接跟 AI 说话。
新的 Audio Upload 则是:
你手上已经有一个录音档,再把它交给 ChatGPT 处理。
例如昨天开完一场 45 分钟客户会议,
手机里已经有:
M4A。
以前可能要先:
上传到转录工具 →
拿到 Transcript →
拷贝到 ChatGPT →
再叫 AI 整理。
现在可以直接:
录音档 → ChatGPT。
可以上传哪些格式?
OpenAI 目前列出的 Audio Format 包括:
WAV、
MP3/MPEG、
OGG/OGA、
PCM、
FLAC、
AAC、
M4A,
以及:
Audio-only WebM、
Audio-only MP4。
所以一般手机录音、
会议录音
最常见的格式大多已经涵盖。
但要注意:
如果 WebM 或 MP4 被辨识成:
Video File
而不是纯音频,
目前不能把它当 Audio Upload 处理。
单一音频最高 512MB
OpenAI 目前列出的 Audio Upload Size Limit 是:
512MB。
很长的录音,
在 Data Analysis 可用时,
可能被分成较小区段处理。
但官方也明确说:
这属于:
Best-effort。
非常长的录音仍有可能:
Timeout。
所以如果是一整天研讨会、
数小时录音,
不要预设:
丢进去一定一次完整处理完。
必要时仍可以先按:
会议、
章节、
主题
切成数段。
最基本的用法:先不要叫它摘要
很多人上传录音后,
第一句可能直接说:
「帮我摘要。」
但如果这份录音真的重要,
比较好的第一步反而是:
先产生 Transcript。
因为后面如果 AI 说:
「客户决定 11 月上线。」
你至少还能回到逐字稿,
确认:
那真的是正式决定,
还是:
「希望 11 月可以上线。」
两句话差很多。
所以第一步可以先要求:
「先完整转成逐字稿,不要先推论结论;听不清楚的地方标示不确定。」
第二步:再把逐字稿变成工作
逐字稿本身其实不是最终成果。
真正有价值的是:
从声音里找出接下来要做什么。
例如一场客户会议,
可以再请 ChatGPT 分成:
已确认
哪些事情真的已经决定?
待办
谁要做什么?
未决问题
哪些事情会议里有谈,
但还没有答案?
待确认
哪些数字、
日期、
名字
需要回去重新核对录音?
这一步比单纯产生:
「五点会议摘要」
更接近真正的工作。
第三步:直接追问录音内容
新的 Audio Upload 还有一个很实用的差别。
录音进到同一段 Chat 后,
你不只是拿到一份 Transcript。
还可以继续问:
「他们在哪一段谈到 Launch Date?」
「客户对价格最大的疑虑是什么?」
「找出所有提到退款条件的地方。」
「这场会议有哪些事情还没有负责人?」
「整理成我要寄给团队的 Follow-up Email。」
也就是录音开始从:
一个文件
变成:
可以继续追问的 Context。
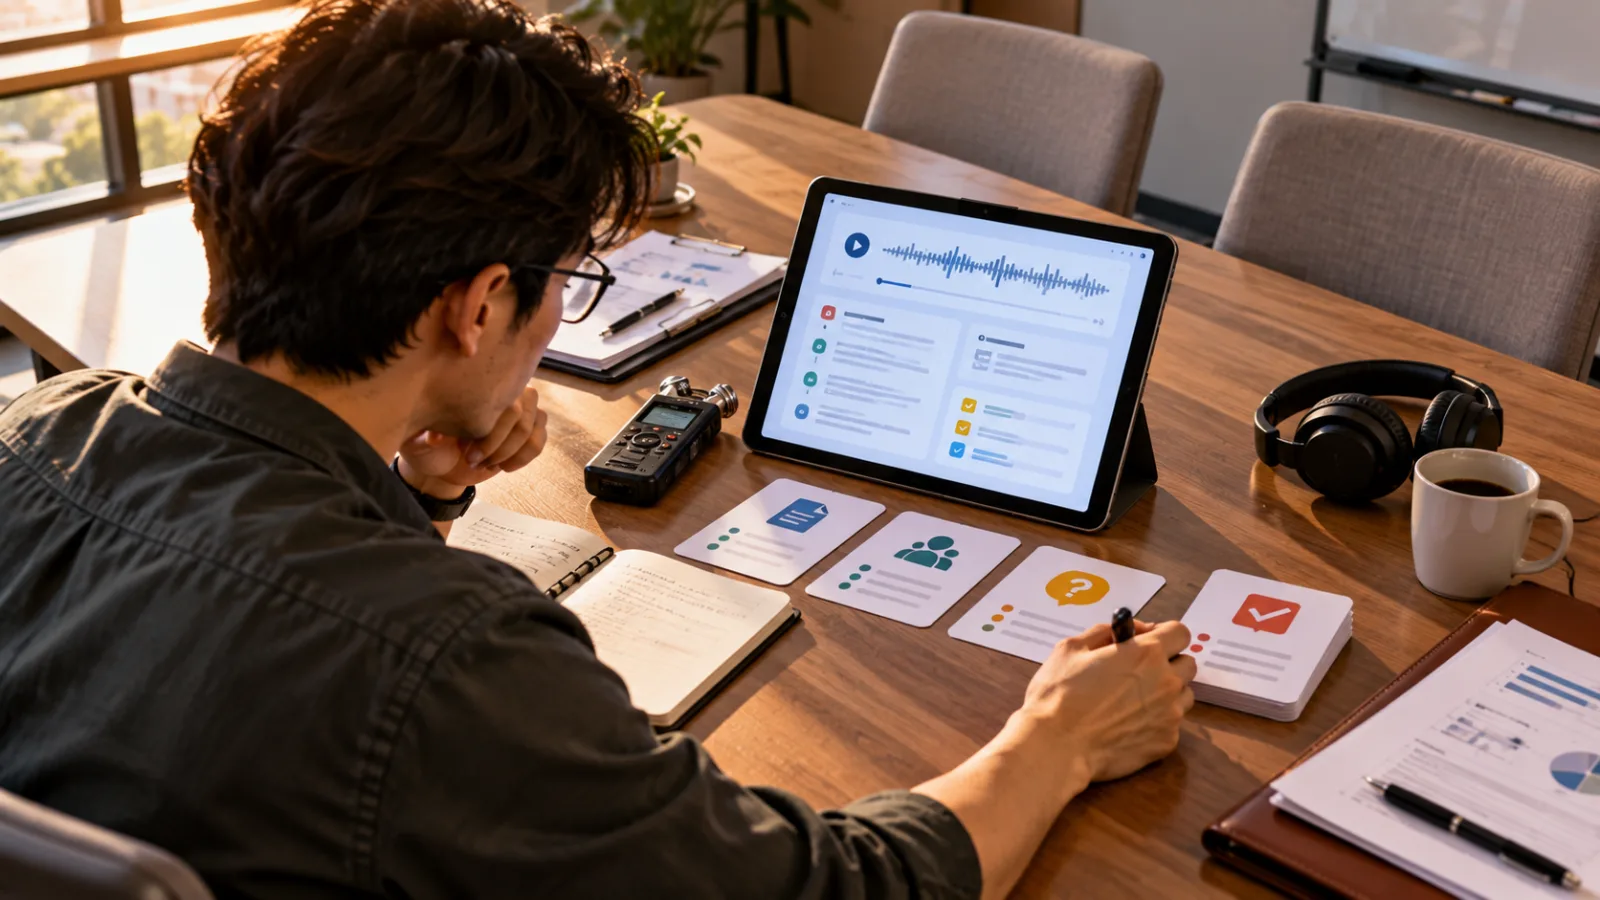
一场会议可以这样直接跑
假设你刚结束一场 40 分钟客户访谈。
把录音丢进 ChatGPT 后,
可以依序做四件事。
1. Transcript
「先产生逐字稿,无法确认的人名、数字与专有名词请标记。」
2. Decisions
「只列出会议中已明确确认的决定,不要把建议或讨论中的方案算成决定。」
3. Actions
「列出下一步,每项附上负责人与期限;录音没有讲清楚就标示待确认,不要自己补。」
4. Follow-up
「根据已确认事项起草会后 Email,把未决问题另外列出,不要替客户做新的承诺。」
这样你真正省掉的,
不是:
「打字速度。」
而是:
会议结束后重新把声音整理成下一步的搬运工作。
访谈也很适合
假设你正在做:
市场研究、
采访、
客户需求访谈。
以前一小时录音,
最麻烦的是重新找:
对方到底在哪里讲过某句重要话。
现在可以先转录,
再问:
「整理受访者重复提到的三个问题。」
或:
「所有谈到价格的内容集中列出。」
但这里要注意一个 Boundary。
AI 整理出的:
「三大问题」
是模型根据录音做的归纳。
不等于:
受访者本人真的说:
「我的三大问题就是这三个。」
正式研究或新闻引用,
仍应回到原始录音确认。
课程录音也不只是做摘要
学生或进修者可以把录音拿来:
创建章节、
整理概念、
找老师举过的例子、
产生复习题。
例如:
「把老师真正解释过的概念和只是提到名字的概念分开。」
或:
「找出三个老师有实际举例的地方。」
这比叫 AI:
「帮我整理重点」
更容易得到有用结果。
最大限制:逐字稿不是百分之百正确
OpenAI 官方特别提醒:
Transcript 可能出错。
而且:
Speaker Identification 可能不可靠。
这点对会议尤其重要。
如果 AI 把:
A 说的话
认成:
B 说的话,
摘要看起来可能还是非常合理,
但责任归属完全错了。
所以涉及:
金额、
日期、
客户承诺、
合约内容、
医疗信息、
法律内容、
正式决策
时,
不要只看 Transcript。
要回听:
Original Recording。
不同语言表现也可能不一样
OpenAI 同样明确表示:
Audio Understanding
与
Transcription Performance
可能因语言不同而有差异。
所以不能因为:
英文会议表现很好,
就直接假设:
中文、
台语、
中英混讲、
多人抢话
也一定一样准。
最好的测试方式很简单:
拿一段你自己熟悉内容的:
10~15 分钟录音
先试。
看看:
人名、
数字、
专有名词、
说话者
哪一类最容易出错。
谁现在可以用?
目前 Audio Upload:
不是 Free Plan 功能。
OpenAI 表示,
它目前提供给:
付费 ChatGPT 订阅
与
Workspace,
包括 Enterprise。
但实际是否出现,
仍可能受:
Workspace Setting、
Region、
Client Version、
Selected Model
影响。
所以如果你没有看到音频可以上传,
不一定代表操作错了。
它也不是 ChatGPT Record Mode
这两个功能不要混在一起。
Audio Upload
你已经有一个:
MP3、
M4A、
WAV
等文件,
再附进 ChatGPT。
ChatGPT Record
则是用 ChatGPT 本身:
直接录会议或 Voice Note,
录完后产生 Transcript 与 Summary。
两个流程的入口不同。
如果你的会议原本就在:
手机录音、
Zoom 录音、
录音笔、
其他系统
里,
Audio Upload 反而更直接。
如果录音里有别人的声音呢?
这也是正式使用前要注意的 Boundary。
会议、
客户访谈、
员工对话
可能包含:
个人数据、
商业机密、
内部决策。
「技术上可以上传」
不等于:
「公司政策或所在地规则一定允许你上传。」
所以工作录音正式丢进 AI 前,
至少先确认:
这份录音你是否有权处理?
里面有没有不应上传的数据?
公司是否有指定 AI 使用政策?
如果不确定,
不要因为整理方便就先整份送出去。
今天真正值得用的不是「AI 会转录」
语音转文字早就不是新功能。
这次比较重要的是:
录音、Transcript、分析、追问与下一步工作,开始留在同一段对话里。
以前工作是:
录音 →
转文字工具 →
下载 →
拷贝 →
ChatGPT →
摘要 →
再改成 Email。
现在可以变成:
**录音 →
ChatGPT →
逐字稿 →
问题 →
决定 →
待办 →
Follow-up。**
如果你每周都有大量:
会议、
访谈、
课程、
语音笔记,
真正值得测的不是:
「转录有没有很酷。」
而是:
它能不能少掉你会后刷新一次信息的那段工作。
推荐阅读
今日 AI 工具|2026/10/03:MAI-Transcribe-2-Streaming,话还没讲完就开始出逐字稿,60 种语言实时辨识