Qwen-Image-2.1 最多可以一次放:
10 张 Reference Images。
看到这个功能,
最直觉的做法很可能是:
人物照丢进去。
商品照丢进去。
服装照丢进去。
场景照丢进去。
风格照也丢进去。
最后说:
「帮我组成一张图。」
但图片愈多,
如果没有说清楚每一张到底负责什么,
AI 反而要自己猜。
今天只学一个方法:
一张图,只给一个主要任务。
不要先写 Prompt,先替图片分工
假设你要做一张:
人物拿着指定包包,
穿指定外套,
站在指定咖啡厅里的广告照片。
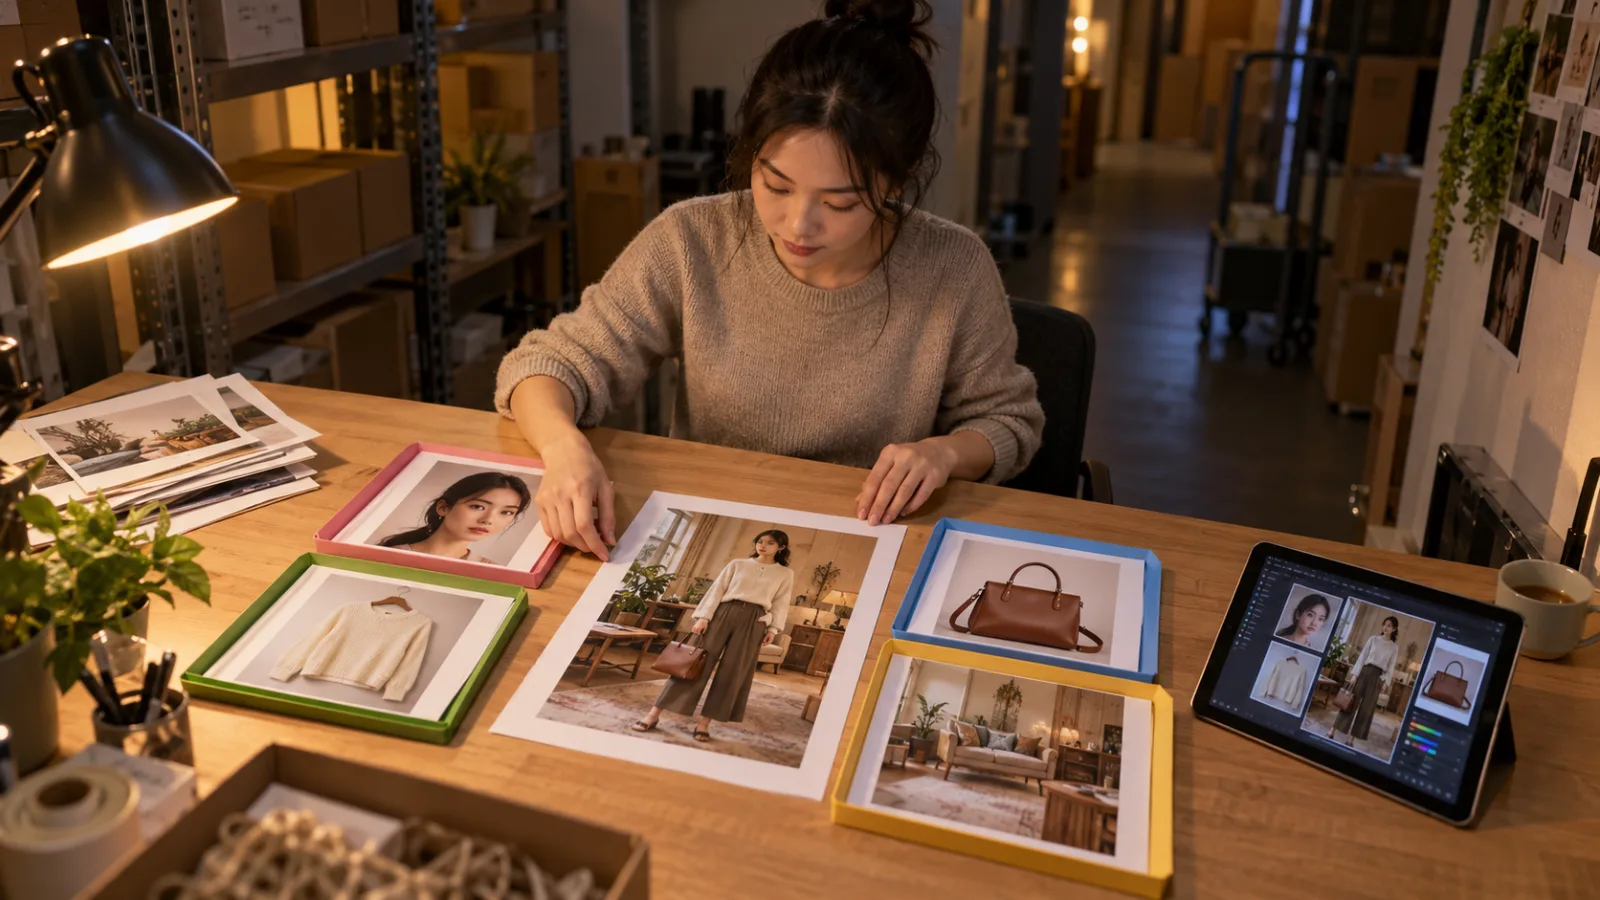
你有四张 Reference。
不要只说:
「参考这四张图帮我生成。」
先把它们分工。
例如:
图 1:人物身份
只参考:
脸、
发型、
大致人物特征。
图 2:衣服
只参考:
外套款式、
颜色、
材质。
图 3:商品
只参考:
包包外观、
比例、
主要结构。
图 4:场景
只参考:
咖啡厅空间、
家具配置、
环境感。
然后才说最后任务:
把图 1 的人物,穿上图 2 的外套,拿着图 3 的包包,放进图 4 的咖啡厅。
这就比:
「请融合这四张图片」
清楚很多。
官方示范本来就是这样做
Qwen-Image-2.1 官方展示一个 Virtual Try-on 范例。
不是拿五张差不多的人物照。
而是五张图各自提供不同东西:
Model。
Clothing。
Shoes。
Bag。
Hat。
最后才组成:
一套完整 Outfit。
官方也展示过:
用 10 张 Furniture References,
组成一个完整 Interior。
这其实已经透露多 Reference 最实用的使用方式:
每张图提供一个明确资产。
不是:
每张都让 AI 全部参考。
为什么「全部参考」容易出问题?
假设图 1 是人物照片。
里面除了脸,
还有:
黑色 T-shirt。
白墙。
一张椅子。
暖色光线。
但你真正想要的只有:
这个人。
如果只告诉 AI:
「参考图 1。」
模型就必须判断:
到底要保留:
人物?
衣服?
背景?
灯光?
姿势?
同时又有图 2、图 3、图 4,
每张都带着自己的:
背景、
光线、
构图、
颜色。
信息很容易互相竞争。
所以更好的方法不是一开始把 Prompt 写得非常长。
而是先回答:
这张 Reference 到底为什么存在?
最简单的格式:图号+角色+要拿什么
可以直接用这个格式:
图 1|人物
只参考人物身份与脸部特征。
图 2|服装
只参考服装款式、材质与颜色。
图 3|商品
只参考商品外型与比例。
图 4|场景
只参考空间与环境。
最后:
把以上四个元素组合成一张 16:9 写实商业照片。
这就是今天整个技巧。
不是背更多 Prompt 关键字。
而是:
先替每一张图分配工作。
在 ComfyUI 里,甚至可以直接用 image_1、image_2
如果是自己跑 Qwen-Image-2.1,
ComfyUI 官方 Workflow Template 也采用很清楚的方式。
Reference Images 可以依序放成:
image_1
image_2
image_3
一直到:
image_10。
Prompt 里则可以直接指定:
<image1>
<image2>
等 Reference。
例如:
「使用 <image1> 的人物,穿上 <image2> 的服装。」
这种写法的价值就是:
不要叫模型猜「上一张」「右边那张」「那个商品照」到底指谁。
图片一多,
直接指定来源会更清楚。
如果是在修改既有图片,第一张的角色更重要
ComfyUI 的 Qwen-Image-2.1 Editing Template 还有一个很实际的规则:
image_1 是 Edit Target。
也就是:
这一张是主要要修改的底图。
其他图片则作为 References。
例如:
image_1:
原本人物照片。
image_2:
新的外套。
image_3:
新的包包。
那任务就很清楚:
不是重新融合三张照片。
而是:
以 image_1 为底,从 image_2、image_3 取得指定元素。
这会比三张图片地位完全相同更容易理解。
不需要的 Reference,不要为了「最多 10 张」硬塞
另一个常见误解是:
既然最多支持 10 张,
是不是放 10 张效果最好?
不是。
「最多 10 张」只是:
模型能接受的上限。
不是:
最佳张数。
假设你只需要:
人物、
商品、
场景。
三张就够了。
再塞:
三张人物角度、
两张风格照、
两张其他场景
并不一定帮助结果。
反而增加模型要处理的:
视觉条件。
所以每加一张前,
只问:
这张图提供了前面没有的新信息吗?
如果没有,
先不要加。
人物需要多角度时,可以例外
「一张图一个任务」
不是说:
同一个人物永远只能给一张照片。
例如你需要提高人物一致性,
可能有:
正面照。
侧面照。
半身照。
这三张都属于:
同一个任务:人物身份。
这时真正要告诉模型的是:
这三张 Reference 都在描述:
同一个人。
不要让它把三张照片理解成:
三个不同人物。
所以更精确的原则是:
一组 Reference,只服务一种角色。
商品也一样
例如一个包包,
正面看不到:
侧边结构。
背面看不到:
扣件细节。
这时可以提供:
正面。
侧面。
背面。
但它们仍然只负责:
商品身份与结构。
不要同时又要求:
其中一张的背景、
另一张的拍摄光线、
第三张的桌面
也全部保留。
这和以前「保留/只改/禁止」不一样
SasaDaily 8 月 6 日曾教过:
局部修图前,
把 Prompt 分成:
保留/只改/禁止。
那一篇解决的是:
一张既有图片要修改时,如何限制修改范围。
今天处理的是另一个问题:
当输入变成很多张 Reference 时,怎么避免不同来源彼此抢角色。
所以今天不是先问:
「哪里不能改?」
而是先问:
「这张图到底负责什么?」
两个方法可以一起用。
最后只记这个顺序
下一次准备丢多张 Reference 给 Qwen-Image-2.1,
不要:
10 张图
→ 一句 Prompt
→ 祈祷模型自己理解。
改成:
先挑真正需要的图片
↓
每张指定一个角色
↓
同一角色的多角度放成一组
↓
最后才描述整张完成图
最简单就是:
图 1 是谁。
图 2 穿什么。
图 3 拿什么。
图 4 在哪里。
当 Reference Image 开始变多,
最重要的 Prompt 技巧反而不是:
写更多。
而是:
不要让一张图片同时负责太多事情。
今天,和 AI 一起进步一点。
每天学会一个 AI 技巧。
每天节省一点时间。
每天提升一点能力。
SasaDaily,陪你一起成长。